4.8. Figurenerkennung: Einführung#
Dieser Abschnitt widmet sich der Vorstellung des Jupyter Notebooks zur automatisierten Erkennung von Figuren in Filmen.
Auch dieses Notebook verwendet den zuvor vorgestellten Workflow und bezieht sich auf die etablierten technischen Grundlagen.
Das Notebook zur Einstellungserkennung hat mit TransNetV2 zugleich das technische Verfahren vorgestellt, mit dem dieses Modell Einstellungen erkennt. Für das Verfahren der Figurenerkennung – bzw. allgemein formuliert der Gesichtserkennung – existiert eine Vielzahl von Modellen, die ähnlich funktionieren. Dieser grundlegende Ablauf verändert sich nicht durch die Verwendung eines anderen Modells und wird voraussichtlich auch in naher Zukunft Bestand haben.
4.8.1. Grundlagen der Gesichtserkennung#
Der Ablauf der Gesichtserkennung lässt sich in vier Schritte einteilen:
Detection
Alignment
Representation
Recognition (beim Vergleich zweier Gesichter auch Verification)
Verfahren zur Gesichtserkennung gehen grundsätzlich davon aus, dass Einzelbilder analysiert werden. Im Folgenden ist daher von Bildern die Rede, die im Fall der Filmanalyse zuvor aus einer Videodatei extrahiert werden (siehe Abschnitt Funktionsweise Computer Vision).
Detection#
Im ersten Schritt Detection gilt es, Gesichter in einem Bild zu erkennen. Für diesen Prozess wird ein spezialisiertes Machine-Learning-Modell benötigt. Die Position eines erkannten Gesichts wird anhand von vier Koordinaten bestimmt, die einen Rahmen um das Gesicht bilden:
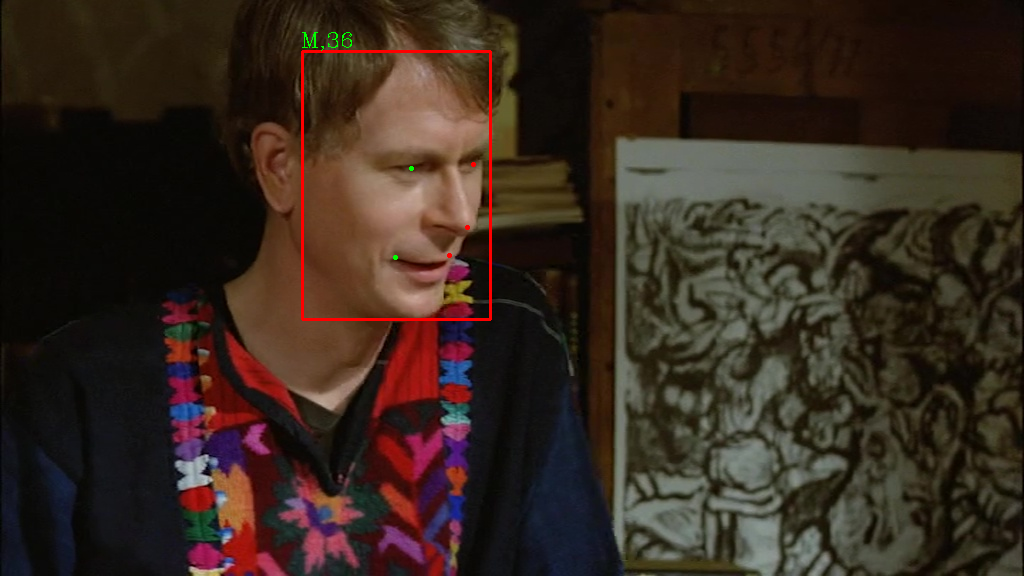
Fig. 4.25 Ein Beispiel für das Ergebnis der Gesichtserkennung mit der Python-Bibliothek Insightface.#
Die Punkte im Gesicht zeigen die erkannten Gesichtsmerkmale an: Augen, Nase, Mund. Die Merkmale auf der linken Gesichtshälfte sind grün, die der rechten Seite rot. Dem auf diese Weise identifizierten Gesicht wird zusätzlich ein Konfidenzwert zugeordnet. Dieser Wert gibt an, mit welcher Wahrscheinlichkeit es sich bei dem markierten Bildausschnitt tatsächlich um ein Gesicht handelt.
In diesem Beispiel wurde dem erkannten Gesicht außerdem ein geschätztes Alter von 36 Jahren sowie die Geschlechtskategorie „männlich“ (M) zugewiesen - erkennbar an dem grünen Wert “M.36” an der linken oberen Ecke des Rahmens um das Gesicht. Solche Schätzungen werden von Modellen zur automatisierten Gesichtsanalyse häufig zusätzlich bereitgestellt, sind jedoch mit erheblicher Vorsicht zu behandeln, da sie häufig keine korrekten oder verwertbaren Ergebnisse liefern. Insbesondere zwischen unterschiedlichen Filmeinstellungen können die Ergebnisse stark variieren und deutlich vom tatsächlichen Alter der Schauspieler:innen bzw. den dargestellten Figuren abweichen. So wurde beispielsweise dem Gesicht der Figur Rita aus dem Film Der geteilte Himmel in einer Einstellung ein Alter von 57 Jahren und die Geschlechtskategorie „männlich“ (M) zugewiesen:
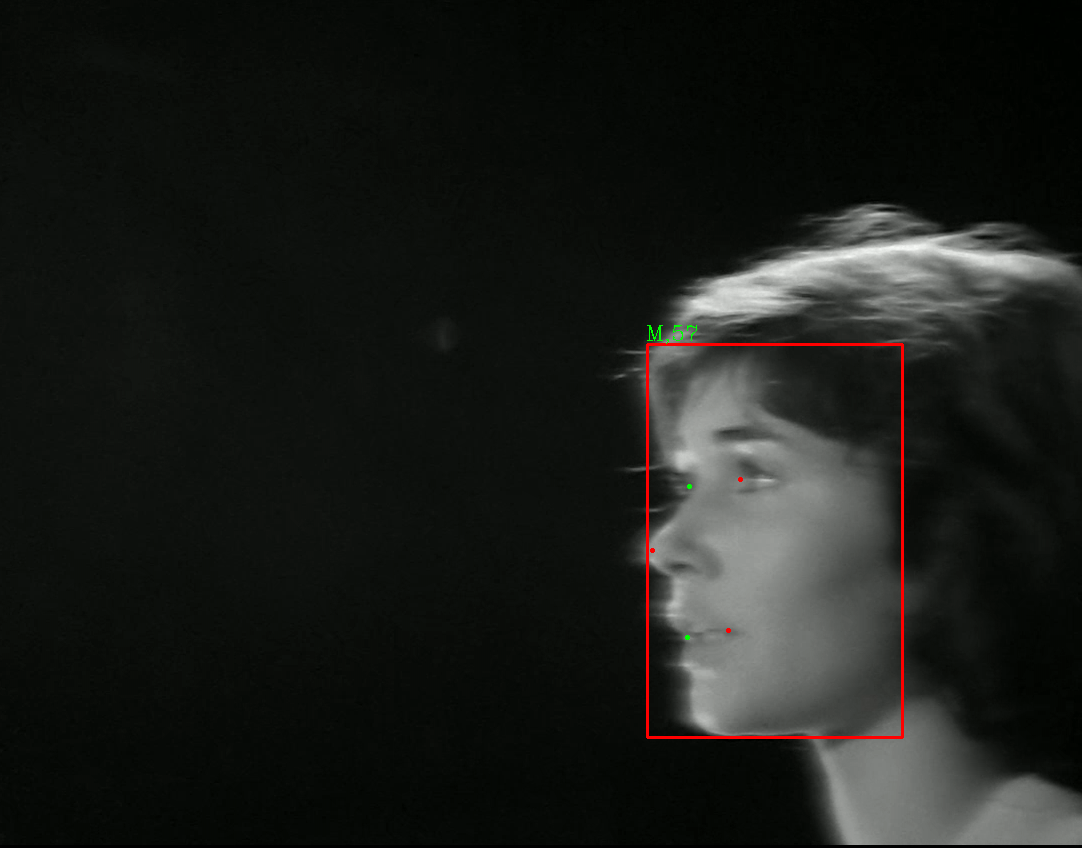
Fig. 4.26 Ein Beispiel für eine deutlich fehlerhafte Erkennung von Alter und Geschlecht mit der Python-Bibliothek Insightface.#
Solche Fehler erklären sich zum Teil auch aus der grundlegenden Funktionsweise der Modelle. Die automatisierte Geschlechtsklassifikation basiert auf erlernten Zusammenhängen zwischen äußeren Erscheinungsmerkmalen und den Geschlechtskategorien der Trainingsdaten. Daher werden im Trainingsprozess häufig Geschlechtsstereotype reproduziert. Zudem beschränken sich viele Modelle, darunter auch das hier verwendete, auf eine binäre Unterscheidung zwischen „männlich“ und „weiblich“. Geschlechtsidentitäten, insbesondere nicht-binäre Identitäten, lassen sich jedoch nicht aus dem äußeren Erscheinungsbild einer Person ableiten.
Aus Perspektive der Gender Studies und der feministischen Filmtheorie ist eine solche automatisierte Geschlechtszuschreibung daher grundsätzlich kritisch zu betrachten. Im Rahmen dieser OER werden die entsprechenden Schätzwerte daher weder gespeichert noch für weitere Analysen verwendet.
Alignment#
Im zweiten Schritt Alignment wird das erkannte Gesicht begradigt und zugeschnitten, um eine höhere Vergleichbarkeit in den nächsten Schritten zu erzielen. Teilweise wird zusätzlich der Hintergrund des Gesichts entfernt. In Python-Bibliotheken wie InsightFace und DeepFace ist dieser Schritt in andere Funktionen integriert und muss nicht im eigenen Code umgesetzt werden.
Representation#
Im dritten Schritt Representation werden aus dem erkannten Gesicht Vektorrepräsentationen, sogenannte Embeddings, erstellt. Hierfür ist ebenfalls ein spezialisiertes Machine-Learning-Modell nötig.
Das vorherige Kapitel erläutert im Abschnitt Zentrale Begriffe im Detail, worum es sich bei einem Embedding handelt. In aller Kürze erklärt bedeutet dies, dass eine mathematische Repräsentation eines Gesichts erstellt wird, anhand derer sich Gesichter im nächsten Schritt miteinander vergleichen lassen.
Recognition#
Im vierten Schritt Recognition können mehrere Gesichter anhand der Embeddings, also den erstellten Vektorrepräsentationen miteinander verglichen werden. Um die Ähnlichkeit zwischen zwei Vektoren festzustellen, lässt sich ein sogenanntes Skalarprodukt berechnen (englisch dot product).
Stellt man sich die Vektoren als Richtungsangaben oder Pfeile in einem Raum vor, so sagt das Skalarprodukt aus, wie sehr sich die Richtungen zweier Pfeile ähneln. Das Ergebnis ist ein Ähnlichkeitswert zwischen 0 und 1, entsprechend einer prozentualen Wahrscheinlichkeit, dass es sich um die Gesichter derselben Person handelt. Anhand eines zuvor festgelegten Schwellwerts kann entschieden werden, ob zwei Gesichter derselben Person zugeordnet werden.
Eine wichtige Frage bei der konkreten Implementierung der Gesichtserkennung ist, welche Gesichter miteinander verglichen werden. Eine Möglichkeit ist ein exploratives Vorgehen, bei dem alle Gesichter miteinander verglichen und anhand eines Schwellwerts in Gruppen eingeteilt werden, die dasselbe Gesicht bzw. dieselbe Figur repräsentieren. Bei der Auswertung eines Langfilms ergibt diese Methode allerdings eine sehr große Anzahl an Figuren, da neben dem zentralen Ensemble auch Statist:innen auftauchen. Ein weiteres Problem der Methode ist, dass die erkannten Figuren namenlos bleiben und händisch klassifiziert werden müssen.
Aus diesen Gründen verwendet unser Notebook die folgende nicht-explorative Methode, bei der die zu findenden Figuren bereits vor der Analyse festgelegt werden.
4.8.2. Vergleichs-Embeddings zur Figurenerkennung#
Für den späteren Schritt der Recognition erstellt unser Notebook noch vor der Analyse Vergleichs-Embeddings für jene Figuren, die tatsächlich erkannt werden sollen.
Hierzu wird nicht eine Videodatei ausgewertet, sondern mehrere ausgesuchte Frames, welche die Figuren idealerweise aus mehreren Perspektiven und in unterschiedlichen Szenen zeigen. Diese Frames (oder Screenshots) müssen händisch ausgewählt und vorbereitet werden. Der Name der Figur lässt sich automatisch aus dem Dateinamen der Bilddateien ermitteln. Dieser muss sich daher aus dem Namen und einer zweistelligen Zahl zusammensetzen, z. B. Erika01.png. Die Bilder dürfen nur ein einziges Gesicht enthalten, da ansonsten unklar bleibt, welches Gesicht zu der zu erkennenden Figur gehört. Bei einer begrenzten Auswahl an Material, etwa aufgrund eines kurzen Trailers, ist es daher sinnvoll, das Bild auf das Gesicht der Figur zuzuschneiden oder die Gesichter anderer Figuren abzudecken:
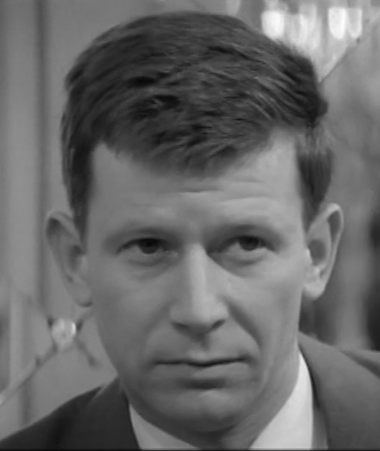
Fig. 4.27 Ein auf das Gesicht zugeschnittener Screenshot.#
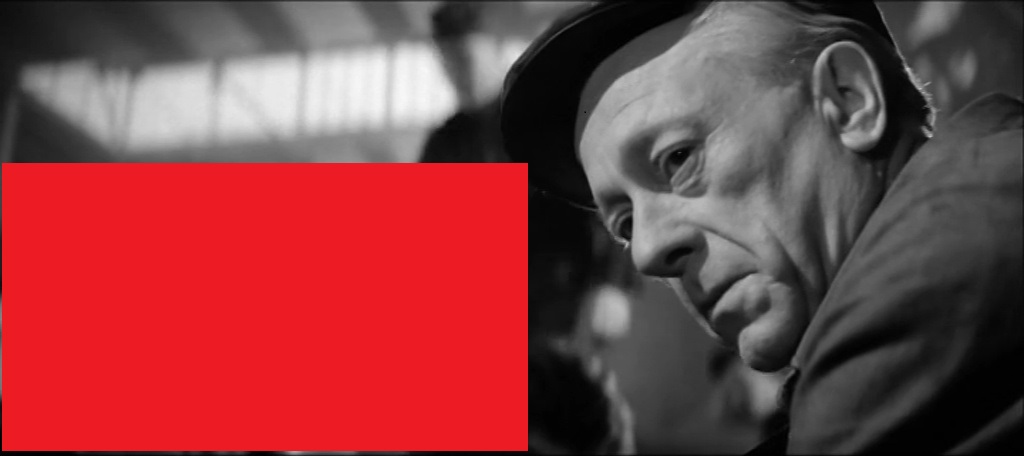
Fig. 4.28 Ein Screenshot mit abgedeckten Gesichtern, die so von der Figurenerkennung ausgeschlossen sind.#
Liegen passende Bilddateien vor, wird pro Figur ein Vergleichs-Embedding vorbereitet, anhand dessen sich später in der Analyse ein erkanntes Gesicht einer Figur zuordnen lässt. Die Schritte in diesem Prozess folgen dem zuvor beschriebenen Ablauf aus Detection und Representation. Die Recognition findet hingegen erst später während der eigentlichen Filmanalyse statt, in welcher die Figuren anhand der Vergleichsembeddings erkannt werden.
4.8.3. InsightFace-Implementierung#
Wie im Abschnitt Auswahl der Modelle erläutert, verwenden wir zur Gesichtserkennung die Python-Bibliothek InsightFace. Neben ihrer ausgezeichneten Genauigkeit und Geschwindigkeit zeichnet sich diese Bibliothek auch dadurch aus, dass für Detection und Representation nicht zwei getrennte ML-Modelle vorbereitet werden müssen. Diese existieren zwar weiterhin im Hintergrund, werden von der Bibliothek allerdings in einem Modellpaket zusammengefasst. Das ermöglicht eine einfachere Anwendung und eine bessere Abstimmung der beiden Modelle. Für Anwendungsfälle, die größere Anpassungen erfordern, etwa um eine höhere Auswertungsgeschwindigkeit zu erzielen, empfehlen wir die Bibliothek DeepFace.
4.8.4. Analysematerial#
Auch für dieses Jupyter Notebook stellen wir als Testmaterial den Trailer zum Film Konrad Wolfs Der geteilte Himmtel zur Verfügung.
Im Jupyter Notebook wird der Trailer erneut automatisch als Teil eines ZIP-Archivs heruntergeladen und im Eingabeordner abgelegt. Die ZIP-Datei enthält neben der readme.md und der DEFA_Nutzungshinweis.md-Datei diesmal auch die Datei xx_shots.csv mit den Ergebnissen der Einstellungserkennung zum Der geteilte Himmel-Trailer.
Zur Erstellung der Vergleichs-Embeddings liefern wir die erwähnten Screenshots der Hauptfiguren mit. Für den Der geteilte Himmel-Trailer haben wir Bilder der Figuren Rita und Manfred ausgewählt.
Wie in den Vorbemerkungen zu diesem Kapitels angemerkt, können wir aus urheberrechtlichen Gründen nicht die Langfilme Konrad Wolfs zum Download zur Verfügung stellen. Mit dem Notebook können jedoch auch Langfilme ausgewertet werden.
4.8.5. Ausgabe#
Für jede analysierte Videodatei werden bis zu vier Ergebnisdateien erstellt. Im Exportordner (EXPORT_PATH) wird für jeden Film ein eigener Unterordner angelegt, dessen Name dem jeweiligen Eingabeordner entspricht. Beim erneuten Export werden weitere Versionen der Ergebnisdateien angelegt. Bestehende Dateien bleiben erhalten.
Die Datei Filmname_characters_frames.csv dokumentiert die Erkennung einzelner Figuren in den analysierten Videoframes. Sie enthält für jede erfolgreiche Erkennung den Figurennamen, den Zeitpunkt in Sekunden und im Format Stunden:Minuten:Sekunden sowie den Ähnlichkeitswert (Dot Product) und den Konfidenzwert der Gesichtserkennung (Detection Score).
Die Datei Filmname_characters_annotations.csv fasst aufeinanderfolgende Erkennungen einer Figur zu längeren Zeitintervallen zusammen. Jede Zeile enthält den Namen der Videodatei, die erkannte Figur sowie den Beginn und das Ende ihres Auftretens in Frames, Sekunden und im Format Stunden:Minuten:Sekunden.
Die Datei Filmname_characters_metadata.csv enthält technische Metadaten, Analyseparameter und statistische Kennwerte der erkannten Figuren. Wie bei der Einstellungserkennung werden die Metadaten als Schlüssel-Wert-Paare gespeichert: Jede Zeile enthält den Namen eines Metadatums und seinen Wert.
Metadatum |
Beschreibung |
|---|---|
Technische Metadaten |
|
|
Dateiname der analysierten Videodatei einschließlich Dateiendung. |
|
Aus dem Dateinamen ermittelter Filmtitel, ohne eine gegebenenfalls angehängte Jahreszahl. |
|
Gegebenenfalls aus dem Dateinamen ermitteltes Erscheinungsjahr des Films. Andernfalls bleibt der Wert leer. |
|
Gesamtanzahl der Frames der Videodatei. |
|
Höhe des Videobildes in Pixeln. |
|
Breite des Videobildes in Pixeln. |
|
Bildrate des Videos in Frames pro Sekunde (FPS). |
|
Berechnete Gesamtlaufzeit des Videos im Format Stunden:Minuten:Sekunden, auf volle Sekunden gerundet. |
|
Name des verwendeten InsightFace-Modellpakets ( |
|
Für die Analyse verwendetes Rechengerät ( |
|
Zeitpunkt des Beginns der Videoanalyse in UTC (ISO-8601-Format). |
|
Benötigte Rechenzeit für die eigentliche Videoanalyse im Format Stunden:Minuten:Sekunden. |
Analyseparameter |
|
|
Mindestwert für den Konfidenzwert der Gesichtsdetektion (Detection). Nur Gesichter, die diesen Schwellenwert erreichen, werden weiterverarbeitet. |
|
Mindestwert für das Skalarprodukt zwischen dem erkannten Gesichts-Embedding und dem Vergleichs-Embedding einer Figur. Bestimmt, ab welcher Ähnlichkeit ein Gesicht einer Figur zugeordnet wird (Recognition). |
|
Anzahl der Frames, die zwischen zwei analysierten Frames übersprungen werden. Bei einem Wert von |
|
Anzahl zusätzlicher Frames, die bei der Zusammenfassung einzelner Erkennungstreffer zu längeren Annotationen überbrückt werden dürfen. |
Analyseergebnisse |
|
|
Anzahl der Frames, die unter Berücksichtigung von |
|
Anzahl der analysierten Frames, in denen die jeweilige Figur erfolgreich erkannt wurde. |
|
Durchschnittliches Skalarprodukt zwischen den erkannten Gesichts-Embeddings und dem Vergleichs-Embedding der Figur. Beschreibt die durchschnittliche Ähnlichkeit der erfolgreichen Zuordnungen. |
|
Durchschnittlicher Konfidenzwert der Gesichtsdetektion für die der Figur zugeordneten Gesichter. |
|
Geschätzte Gesamtdauer des Auftretens der Figur in Sekunden. Berechnet aus der Anzahl erfolgreicher Erkennungen, dem Abstand zwischen analysierten Frames und der Bildrate. |
|
Geschätzte Gesamtdauer des Auftretens der Figur im Format Stunden:Minuten:Sekunden. |
Der Platzhalter Figurenname wird durch den Namen der jeweiligen Figur ersetzt. Ein Erscheinungsjahr wird nur dann erkannt, wenn der Videodateiname vor seiner Endung mit _Jahr endet, beispielsweise Der_geteilte_Himmel_1964.mp4. Die geschätzte Gesamtdauer ihres Auftretens basiert auf den erfolgreich analysierten Frames und kann von der tatsächlichen Auftrittsdauer abweichen.
Schließlich wird eine Datei Filmname_characters_annotations.eaf erzeugt. Anhand dieser lassen sich die Figurenerkennung und die Einstellungserkennung gemeinsam in VIAN importieren, überprüfen und weiterbearbeiten. Für jede erkannte Figur enthält diese .eaf-Datei die Informationen für eine eigene Annotationsspur, die deren Auftritte im Film festhält und anzeigt. Wurde zusätzlich eine CSV-Datei mit den Ergebnissen der Einstellungserkennung für die analysierte Videodatei bereitgestellt, werden die Einstellungen in der Spur shots gespeichert und angezeigt. Außerdem werden in diesem Fall jeder Figur auf einer zusätzlichen Spur jene Einstellungen zugeordnet, in denen sie für mindestens einen Frame erkannt wurden (Figurenname_matched).
Alle Ergebnisdateien eines Films werden in einem eigenen Unterordner gespeichert. Beim wiederholten Export werden zusätzliche Dateiversionen angelegt. In Google Colab kann der gesamte Exportordner als ZIP-Archiv heruntergeladen werden.