4.2. Vorstellung des Workflows#
In diesem Abschnitt wird der Workflow vorgestellt, der den in dieser OER thematisierten Verfahren zur automatisierten Annotation von Filmen zugrunde liegt. Er lässt sich auch für andere Analyseaufgaben anpassen, etwa indem ein anderes Machine-Learning-Modell eingebunden wird. Der Ablauf orientiert sich an der Pipeline for Distant Viewing von Taylor Arnold und Lauren Tilton (Arnold and Tilton, 2023). Sie übertragen dabei einen in der Datenwissenschaft verbreiteten Arbeitsablauf auf die Analyse von Bild- und Filmmaterial.
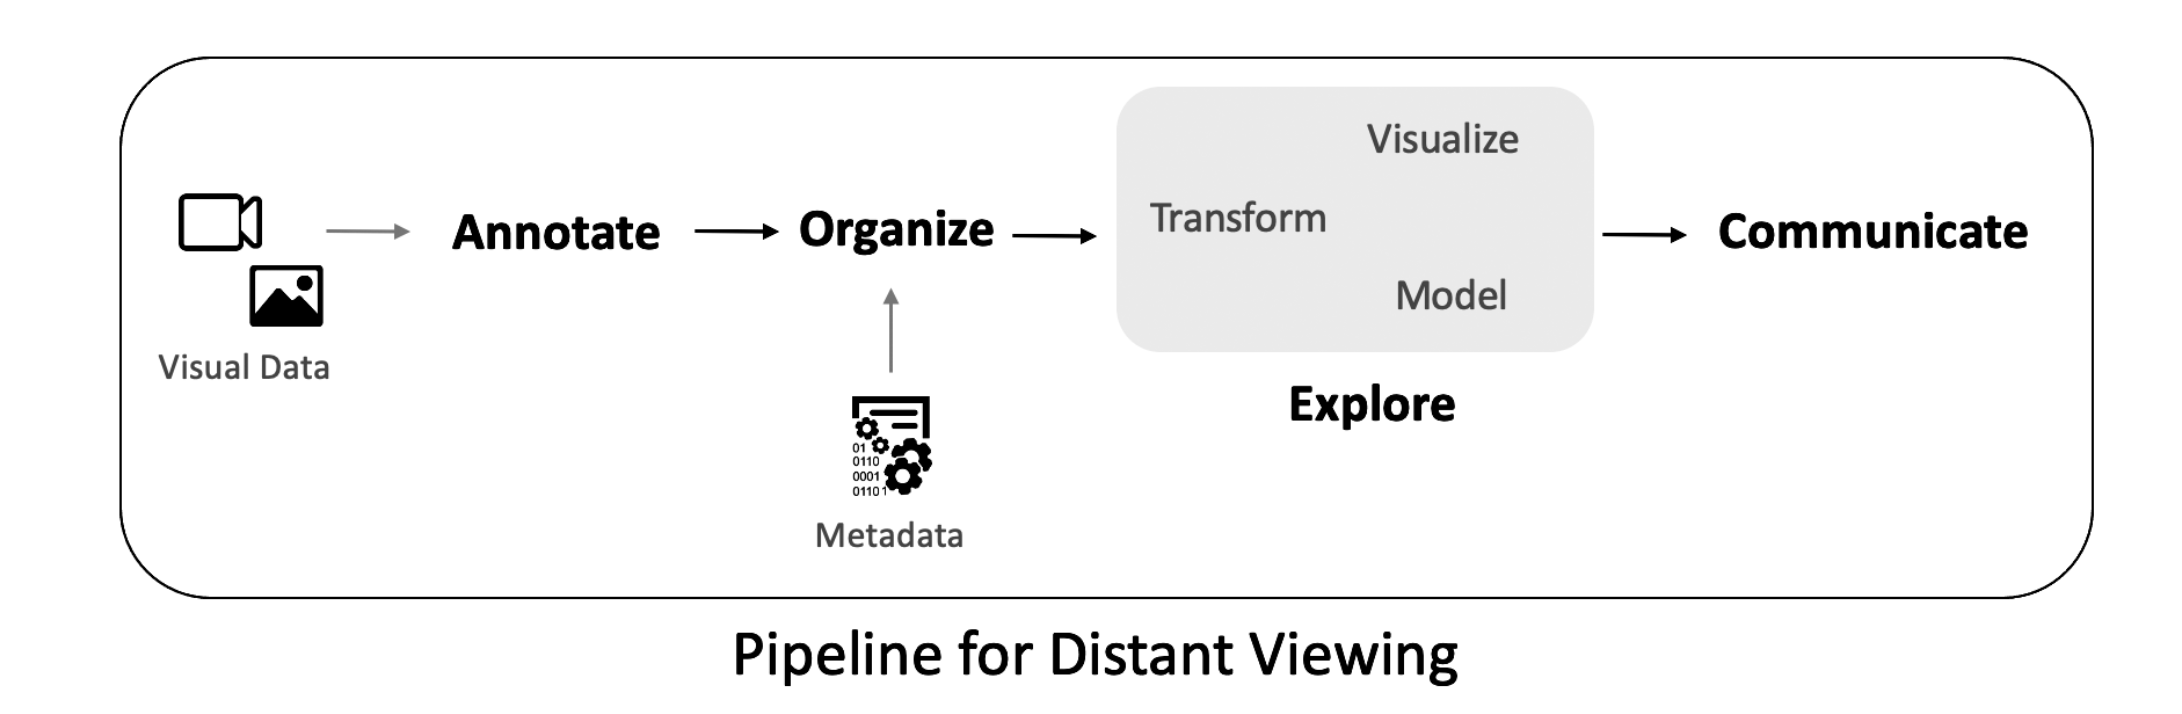
Fig. 4.2 Visualisierung der von Arnold und Tilton entwickelten Distant Viewing Pipeline (Arnold and Tilton, 2023), (p. 35).#
Für die hier vorgestellten Verfahren orientieren wir uns außerdem am Distant Viewing Toolkit (vgl. auch Kapitel zu Einsatzbereichen für die Filmanalyse) und an den dazugehörigen Jupyter Notebooks. Wie auch das Distant Viewing Toolkit verwenden wir zur automatisierten Erstellung der Annotationen Skripte in der Programmiersprache Python. Python ist für diese Aufgaben sehr gut geeignet, weit verbreitet und gut dokumentiert.
Unser Workflow in unseren beiden Jupyter Notebooks zur Einstellungs- und Figurenerkennung gliedert die Analyse der Videodateien in mehrere Schritte. Zuerst werden die benötigten Parameter für die Einstellungen des Notebooks festgelegt (z.B. angelegte Schwellenwerte) und die technische Arbeitsumgebung vorbereitet. Dann werden die Daten eingelesen und analysiert. Zum Schluss werden die Ergebnisse aufbereitet und exportiert.
Die hier für diese Schritte verwendeten Bezeichnungen finden sich auch in den Jupyter Notebooks wieder, sodass jeder der im Folgendem beschriebenen Abschnitte einer konkreten Funktion bzw. einem konkreten Arbeitsschritt im Jupyter Notebook zugeordnet werden kann.
Die darauf folgenden Schritte des Workflows - die Prüfung, Visualisierung und Auswertung der erhaltenen Annotationsdaten - erfolgen außerhalb der Juypter Notebooks zur Einstellungs- und Figurenerkennung. Für die Überprüfung der automatisiert erstellten Annotationen verwenden wird das Annotationstool VIAN, für die Visualisierung setzten wir zwei weitere Jupyter Notebooks mit Python-Skripten ein, bevor schließlich die Visualisierungen im letzten Schritt des Workflows explorativ ausgewertet werden.
Wir beginnen mit der Beschreibung der Workflow-Schritte innerhalb der Jupyter Notebooks zur Einstellungs- und Figurenerkennung.
4.2.1. Festlegen von Parametern und Schwellenwerten#
Zu Beginn eines jeden Notebooks werden die Einstellungen festgelegt, die das Jupyter Notebook zu seiner Ausführung benötigt. Wir unterscheiden für diese Einstellungen zwischen Parametern und Schwellenwerten. Auf technischer Ebene sind Parameter und Schwellenwerte Variablen: benannte Platz-Halter für einen Wert, der im Code Anwendung findet. Diese Werte, für die die Variablen im weiteren Verlauf des Notebooks stehen, werden in diesem Abschnitt festgesetzt und können dort verändert werden.
Parameter legen zum Beispiel fest, wo die Eingabedateien liegen, wohin Ergebnisse gespeichert werden oder welche Frames eines Films analysiert werden sollen.
Schwellenwerte bestimmen, ab welchem Wert ein Analyseergebnis als Treffer gilt. Bei der automatisierten Erkennung von Einstellungsübergängen kann ein Verfahren beispielsweise für jeden möglichen Übergang einen Wahrscheinlichkeitswert berechnen. Ein Schwellenwert von 0,5 bedeutet dann, dass Wahrscheinlichkeitswerte ab 0,5 als erkannte Übergänge behandelt werden.
Ein höherer Schwellenwert führt tendenziell zu weniger, dafür sichereren Treffern. Ein niedrigerer Schwellenwert kann mehr mögliche Übergänge erfassen, aber auch mehr falsche Treffer erzeugen.
Die Wahl der passenden Werte hängt davon ab, was die Analyse leisten soll, um welches Filmmaterial es sich handelt und wie die Ergebnisse anschließend verwendet werden sollen. Die Festlegung von Schwellenwerten ist daher ein wichtiger Teil des Annotationsprozesses.
4.2.2. Technische Vorbereitung#
Bevor die Analyse beginnen kann, muss die Programmierumgebung für die weitere Ausführung des Notebooks vorbereitet werden. Dazu gehören die Installation und der Import von Programmbibliotheken, die Bereitstellung des Analysematerials und gegebenenfalls der Download und das Konfigurieren eines Machine-Learning-Modells.
Installation der Programmbibliotheken#
Programmbibliotheken sind Sammlungen vorgefertigter Funktionen, die eine Programmiersprache wie Python um zusätzliche Möglichkeiten erweitern. Für eine Filmanalyse können beispielsweise Bibliotheken benötigt werden, um Videos einzulesen, Tabellen zu bearbeiten, ein Machine-Learning-Modell auszuführen oder Annotationsdateien zu erstellen.
Die Installation fügt die benötigten Bibliotheken zur Programmierumgebung hinzu. In einer lokalen Umgebung müssen bereits installierte Bibliotheken normalerweise nicht bei jeder Sitzung erneut installiert werden. Bei cloudbasierten Umgebungen wie Google Colab wird die Umgebung typischerweise nach dem Beenden zurückgesetzt. Daher müssen dort die Bibliotheken bei einer neuen Sitzung erneut installiert werden.
Import der Programmbibliotheken#
Nach der Installation müssen die Bibliotheken noch importiert werden. Beim Import wird Python mitgeteilt, welche Bibliotheken in der aktuellen Sitzung verwendet werden sollen. Eine installierte Bibliothek ist also nicht automatisch für jeden Code verfügbar, erst durch den Import kann auf ihre Funktionen zugegriffen werden.
Manche Arbeitsabläufe verwenden außerdem Funktionen aus der Standardbibliothek von Python, die zwar importiert, aber nicht separat installiert werden müssen.
Download des Analysematerials#
Die zu analysierenden Dateien können lokal abgelegt oder aus einer Onlinequelle heruntergeladen werden.
In den Jupyter Notebooks werden zu Übungszwecken die Trailerdateien zur Analyse aus einem Online-Repositorium heruntergeladen und in einem Ordner abgelegt – alternativ können zudem eigene Videodateien heruntergeladen werden.
Vorbereitung des Machine-Learning-Modells#
Wenn ein Verfahren ein Machine-Learning-Modell verwendet, muss dieses vor der Analyse der Videodaten noch vorbereitet werden. Dazu gehören je nach Verfahren auch der Download des Modells und dessen Konfiguration. Es ist etwa wichtig, ein Modell vor der Analyse vom Trainingsmodus in den Evaluationsmodus zu versetzen. In diesem Modus berechnet es Vorhersagen, statt weiter trainiert zu werden. (Zu Modellen und deren Training vgl. auch das Kapitel zu Zentrale Begriffe und Konzepte.)
4.2.3. Einlesen und Analyse des Videomaterials#
Nun beginnt die eigentliche Analyse. Welche Schritte dabei konkret nötig sind, hängt von der Analysemethode ab.
Erfassung der technischen Videometadaten#
Zunächst werden die abgelegten Videodateien erfasst, ihr Ablageort gespeichert und Metadaten wie Auflösung und Laufzeit ermittelt. Metadaten helfen insbesondere dabei, Analyseergebnisse einzuordnen.
Anwendung des Modells#
Nachdem die Videodateien vorbereitet worden sind, wird das ausgewählte Analyseverfahren auf die Videodaten angewendet. Bei einer automatisierten Erkennung von Einstellungsübergängen kann das Verfahren beispielsweise für einzelne Frames berechnen, wie wahrscheinlich jeweils ein Übergang an der Stelle des jeweiligen Frames ist. Andere Methoden erkennen möglicherweise Objekte, Gesichter oder weitere visuelle Merkmale in den Videodaten.
Hier unterscheidet sich das Vorgehen je nach dem gewählten Verfahren bzw. Modell erheblich, etwa dahingehend, ob ein Film zuerst in Frames aufgeteilt werden muss oder nicht. Parameter und Schwellenwerte kommen insbesondere während dieses Schritts zum Einsatz und bestimmen maßgeblich das Ergebnis der Analyse.
Tabellarische Aufbereitung des Ergebnisses#
Analyseergebnisse liegen zunächst oft in einer Form vor, die sich nur schwer weiterverarbeiten lässt, etwa als Liste von Werten. Bevor die Ergebnisse exportiert und verwendet werden können, z.B. für die weitere Analyse in anderen Tools, müssen diese daher in ein tabellarisches Format transformiert werden.
Berechnung der Analysemetadaten#
Anschließend werden Metadaten zum Analyseergebnis gesammelt und berechnet. Hierzu gehören etwa die gewählten Parameter, Schwellenwerte und Dauer der Analyse, aber auch Durchschnittswerte des eigentlichen Ergebnisses.
4.2.4. Export der Ergebnisse#
Die Ergebnisse sind damit soweit aufbereitet, das sie auch außerhalb von Python weitergenutzt werden können. Zu diesem Zweck müssen sie in externe, interoperable Formate exportiert werden.
Export der Tabellen als CSV-Datei#
Ein dabei besonders häufig verwendetes Format ist CSV (comma separated values). Das Format speichert tabellarische Daten als Text, in dem Werte durch Komma als Trennzeichen voneinander abgegrenzt werden. CSV-Dateien lassen sich zum Beispiel in Tabellenkalkulationsprogramme wie Microsoft Exel oder OpenRefine importieren, eignen sich darüber hinaus aber auch zur Erstellung von Visualisierungen mit verschiedenen Tools. (Die Verwendung von OpenRefine wird in der OER zu OER zu Studentischen Filmen an der Filmuniversität genauer erklärt, ebenso das csv-Dateiformat.)
Export der Annotationen als EAF-Datei#
Für die Arbeit mit Annotationen zu filmischem Material eignet sich zudem das Format EAF, das ELAN Annotation Format. In diesem Format können Annotationen als Zeitabschnitte mit einem Start- und Endzeitpunkt gespeichert werden, ähnlich einer Untertitelspur.
Eine EAF-Datei kann in VIAN oder anderen geeigneten Annotationsprogrammen geöffnet und weiterbearbeitet werden. So können die automatisch erstellten Annotationen gemeinsam mit dem analysierten Video gesichtet, korrigiert und inhaltlich ergänzt werden.
4.2.5. Sichtung der Ergebnisse#
Die folgenden Schritte unseres Workflows finden nun außerhalb der Jupyter Notebooks zur automatisierten Annotation von Videodateien statt. Da es während der automatisierten Annotation zu Fehler kommen kann, ist es essenziell wichtig, die Ergebnisse zu sichten und zu überprüfen. Während einer Sichtung sollten falsche oder übersehene Treffer korrigiert, vor allem aber auch die generelle Qualität des Verfahrens eingeschätzt werden. Häufig bedürfen etwa die Parameter und Schwellenwerte einer Feinjustierung, die vom jeweiligen Film abhängig ist und erst nach einem ersten Durchlauf eingeschätzt werden kann. Nach den Feinjustierungen können die Ergebnisse erneut gesichtet und beurteilt werden, ob sich die Qualität der automatisiert erhobenen Annotationen verbessert hat.
Innerhalb dieser OER verwenden wir zur Sichtung VIAN, ein open-source Annotationsprogramm für die Filmanalyse, das an der Universität Zürich entwickelt wird. In VIAN können die Ergebnisse als EAF-Datei importiert und mit dem analysierten Videomaterial verknüpft werden. So lassen sich Annotationen framegenau mit dem Material abgleichen, anhand dessen sie erstellt wurden.
Das spätere Kapitel zu den Technischen Grundlagen führt in die Installation und Nutzung von VIAN ein.
4.2.6. Visualisierung der Ergebnisse#
Ein Mittel zur explorativen Auswertung der Ergebnisse ist die Datenvisualisierung. Eine Visualisierung ist ein möglicher erster Schritt in der Auswertung und kann u.a. dabei helfen, Forschungsfragen zu präzisieren. Welche Visualisierung sinnvoll ist, hängt jedoch vom jeweiligen Forschungsinteresse ab – die selben Daten lassen sich in einer Vielzahl von Varianten visualisieren.
Zur Erstellung von Visualisierungen können Programme zur Tabellenkalkulation wie Microsoft Excel oder Online-Plattformen wie Datawrapper oder RAWGraphs genutzt werden. Im Rahmen dieser OER verwenden wir allerdings auch für die Visualisierung die Programmiersprache Python, um Visualisierungen mit interaktiven Elementen zu erstellen. Weitere Informationen zur Datenvisualisierung finden sich auch in der OER zu Studentischen Filmen an der Filmuniversität
4.2.7. Spezifische Implementierung#
Wie in diesem Abschnitt bereits dargelegt wurde, ist das gewählte Verfahren ausschlaggebend dafür, wie dieser Workflow im Detail ausgestaltet wird. Ein Machine-Learning-Modell gibt bereits vor, welcher Input, welche Ausgaben, und welche Einstellungen in Form von Parametern und Schwellenwerten im Code berücksichtigt werden müssen. Daher ist es wichtig, ein zum eingenen Forschungsinteresse passendes Modell auszuwählen. Das folgende Kapitel widmet sich genau diesem Prozess.
4.2.8. Literatur#
Arnold, T., & Tilton, L. (2023). Distant Viewing: Computational Exploration of Digital Images. The MIT Press. doi:10.7551/mitpress/14046.001.0001