

4.9. 🚀 Automatische Erkennung von Figuren mit InsightFace#
Dieses Jupyter Notebook annotiert das Auftreten von Figuren in einer Videodatei mithilfe von InsightFace. Dabei werden zunächst Gesichter erkannt (face detetction) und darauf aufbauen auf der Grundlage von Referenzabbildungen entsprechende Figuren (face recognition). Als Ergebnis entstehen:
eine Tabelle im
.csv-Format mit Namen der Videodatei, Namen der erkannten Figuren, Start und Endzeit der Erkennung einer Figur in Frames, Start und Endzeit der Erkennung einer Figur in Sekunden, Start und Endzeit der Erkennung einer Figur in Stunden:Minuten:Sekunden,eine Tabelle im
.csv-Format mit der Zeit in Sekunden, der Zeit in Stunden:Minuten:Sekunden, dem durchschnittlichen Skalarprodukt, dem durchschnittlichen predicition-score und dem Namen der Figureine weitere Tabelle im
.csv-Format zu den Metadaten der Analyse,eine ELAN-Datei (
.eaf) zum Import und zur Sichtung der Annotationsdaten in VIAN oder anderen Programmen zur Videoannotation.
Beim erneuten Export werden weitere Versionen der Ergebnisdateien angelegt. Bereits vorhandene Dateien bleiben erhalten.
Der Arbeitsablauf ist in vier Abschnitte gegliedert: Festlegen der Parameter, technische Vorbereitung, Automatische Figurenerkennung und Export der Ergebnisse. Die Texte zwischen den Codeblöcken erläutern vor allem den Zweck dieser einzelnen Schritte und die Bedeutung der erzeugten Dateien, während die Kommentare innerhalb des Codes auf Englisch dessen Funktionsweise vermitteln.
Weitere Informationen zur Funktionsweise dieses Notebooks bietet das Einführungskapitel zur Figurenerkennung innerhalb der OER.
4.9.1. Ausführung des Notebooks#
Im Jupyter Book, also als Seite innerhalb der OER, ist das Ergebnis der Ausführung gespeichert und kann nachvollzogen werden, ohne den Code selbst auszuführen. Wir empfehlen allerdings für ein tieferes Verständnis und die Bearbeitung der späteren Übungen, das Notebook in einer Cloud Umgebung oder lokal auszuführen.
Cloud-Umgebung: Klicken Sie oben rechts in der Menüleiste auf das Raketen-Symbol 🚀 und wählen Sie „Colab“, um das Notebook auszuführen. Denken Sie daran, den Laufzeittyp zu ändern, um das Notebook ggf. mit einer GPU auszuführen.
Lokale Umgebung: Klicken Sie oben rechts in der Menüleiste auf das Download-Symbol ↓ und wählen Sie „.ipynb“, um das Notebook herunterzuladen und lokal auszuführen. Abhängig von Browser und Betriebssystem müssen Sie die Datei mit Rechtsklick auf „.ipynb“ ggf. manuell herunterladen.
Wir empfehlen die Codeblöcke einzeln nacheinander auszuführen und nicht mit Funktionen wie “Alle ausführen” in Colab oder “Run All Cells” in anderen Anwendungen zur Ausführung von Jupyter Notebooks. Die separate Ausführung der Codeblöcke erleichtert das Verständnis der mit ihnen verbundenen Funktionen und gewährleistet, dass alle vorbereitenden Schritte für nachfolgende Codeblöcke bereits durchlaufen wurden.
4.9.2. Festlegen der Parameter#
In diesem Abschnitt werden die zentralen Parameter für die spätere Analyse festgelegt. Sie können an dieser Stelle angepasst werden, ohne Änderungen im weiteren Code vornehmen zu müssen. Die dafür verwendeten Variablen werden alle großgeschrieben, um sie von den späteren Variablen zur Strukturierung und Erklärung des Codes abzugrenzen. Zum Erlernen der Funktionen des Codes in diesem Jupyter Notebook und für einen ersten Probelauf empfiehlt es sich, die voreingestellten Werte beizubehalten.
Zuerst werden die Ordner für die zu analysierenden Videodateien (VIDEO_PATH) und den Export der Annotationsergebnisse (EXPORT_PATH) festgelegt. Sollten die Ordner noch nicht existieren, werden sie mit entsprechender Benennung beim Ausführen des Codeblocks automatisch erstellt.
Im Video-Ordner wird die zu analysierende Videodatei abgelegt. Im gleichen Ordner werden auch die entsprechenden Referenzabbildungen für die Figurenerkennung abgespeichert. Für jede zu erkennende Figur muss mindestens eine Referenzabbildung hinterlegt werden, mehrere Abbildungen einer Figur, z.B. aus verschiedenen Kamerawinkeln, erhöhen die Wahrscheinlichkeit einer korrekten Erkennung. Optional kann im gleichen Ordner auch eine .csv-Datei mit den zuvor erkannten Einstellungen aus dem Jupyter Notebook Automatische Erkennung von Einstellungen mit TransNetV2 abgelegt werden. Diese ist für die Figurenerkennung nicht erforderlich. Sie ermöglicht jedoch, beim Export der .eaf-Datei zusätzlich die erkannten Einstellungen und deren Übereinstimmungen mit den Figurenauftritten als eigene Annotationsebenen zu speichern. Ohne diese Datei werden ausschließlich die Figurenauftritte annotiert.
Es wird nur eine Videodatei pro Ordner unterstützt. Falls mehrere Videos in einem Ordner abgelegt werden, wird beim Ausführen des Notebooks darauf hingewiesen. Für jede zu analysierende Videodatei sollte im Video-Ordner ein eigener Unterordner angelegt werden. Das bedeutet auch, dass für jedes Video eigene Referenzbilder im gleichen Ordner, in der auch die Videodatei liegt, hinzugefügt werden müssen und Videos sich keine Referenzbilder “teilen” können. Hinsichtlich der Anzahl an Ordnern gibt es keine Beschränkungen. Videodateien in unterschiedlichen Ordnern können dieselben Namen haben. Dieser muss zudem nicht mit dem Ordnernamen identisch sein.
In diesem Ordner werden auch die für diese OER vorbereiteten Testdateien im zip-Format abgelegt. Die Testdateien beinhalten neben dem zu analysierenden Trailer die passenden Referenzabbildungen und die Annotationsdatei zur Einstellungserkennung. Sie sind für die Ausführung dieses Jupyter Notebooks zu Lernzwecken vorgesehen und wir empfehlen, diese hierfür auch zu verwenden.
4.9.3. Festlegen der Schwellenwerte#
Des Weiteren werden zwei Schwellenwerte festgelegt. Eine ausführlichere Einführung zu Schwellenwerten finden Sie im OER-Abschnitt zu zentralen Begriffen und Konzepten.
Der durch FACE_DETECTION_THRESHOLD festgelegte Schwellenwert muss während der Gesichtsdetektion (Detection) überschritten werden, damit das erkannte Gesicht weiter verarbeitet wird.
CHARACTER_RECOGNITION_THRESHOLD legt den Schwellenwert fest der überschritten werden muss, damit eine Figur bei der Figurenerkennung (Recognition) erkannt und einem entsprechenden Frame in der Videodatei zugeordnet wird. Der zu prüfende Wert beruht auf dem Skalarprodukt zwischen den Embeddings (siehe Zentrale Begriffe und Konzepte).
SKIP_FRAMES gibt die Anzahl an Frames an, die nach der Auswertung eines Frames übersprungen werden. Bei einem Wert von 0 werden keine Frames übersprungen, jedoch benötigt die Auswertung aller Frames einer Videodatei eine längere Analysezeit. Je höher der Wert von Skip Frames gesetzt wird, desto weniger Frames müssen insgesamt analysiert werden und die benötigte Rechenzeit für die Figurenerkennung nimmt entsprechend ab. Allerdings kann dadurch auch die Genauigkeit der Erkennungsleistung abnehmen.
Mit TOLERANCE_FRAMES wird die Anzahl an fehlenden Frames festgelegt, über die hinweg Frames zu einer langen Annotation zusammengefügt werden. Einzelne Frames können z.B. bei fehlerhaften Erkennungen durch ungünstige Kamerawinkel oder schlechter Bildqualität fehlen. Möglich ist auch, dass Figuren im Bild bei der Erkennung durch mit SKIP_FRAMES übersprungene Frames nicht erfasst wurden. TOLERANCE_FRAMES gewährleistet also, dass in diesen Fällen dennoch eine Annotation für die Figur erstellt wird.
Wenn DOWNLOAD_TESTFILES auf True gesetzt ist, werden die vorbereiteten Trailer und Screenshots heruntergeladen. Um eigene Filme zu verwenden, sollte dieser Parameter daher auf False gestellt werden. Eigene Videodateien und Referenzabbildungen müssen in den bei VIDEO_PATH festgelegten Ordner abgelegt werden. In unserem Beispiel ist dies der Ordner “video_characters”.
Es können auch eigene .zip-Archive von Online-Speicherplätzen heruntergeladen werden. Hierzu muss ein entsprechender Download-Link innerhalb von Anführungszeichen der Variable CUSTOM_ZIP_LINK zugeordnet werden, z.B. CUSTOM_ZIP_LINK = "https://example.org/video_archive.zip". Wichtig ist dabei, dass es sich um einen Direktlink zur .zip-Datei handelt, nicht um einen Link zu einer Website oder einer Datei in einem anderen Format. Außerdem sollte beim Download mehrerer Archive nacheinander jeweils die Variable CUSTOM_ARCHIVE_NAME geändert werden, da Archive mit demselben Namen nicht erneut heruntergeladen werden. Die Option zum Download eigener Dateien ist besonders bei der Analyse von Langfilmen in Google Colab hilfreich, da die Videodateien dadurch nicht manuell und unter erheblichem Zeitaufwand in die Colab-Umgebung hochgeladen werden müssen. Der Download von einem Online-Speicher wie z.B. einem Cloud-Dienst benötigt in der Regel weniger Zeit.
Mit DIVIDER wird die Art der Trennlinie zwischen den Ausgaben des Jupyter Notebooks festgelegt.
import os

# Create input and output directories if they do not already exist.
VIDEO_PATH = "videos_characters"
os.makedirs(VIDEO_PATH, exist_ok=True)
EXPORT_PATH = "export_characters"
os.makedirs(EXPORT_PATH, exist_ok=True)

# Minimum detection confidence required to accept a face.
FACE_DETECTION_THRESHOLD = 0.3
# Minimum embedding similarity required to assign a face to a character.
CHARACTER_RECOGNITION_THRESHOLD = 0.3
# Analyse every (SKIP_FRAMES + 1)th frame (every fifth frame if set to 4).
SKIP_FRAMES = 4

# Allow an additional frame gap when merging detections into annotation intervals.
TOLERANCE_FRAMES = 25

# Download the provided test material when enabled.
DOWNLOAD_TESTFILES = True

# Add your own custom link inside quotes to download additional files into the video folder.
CUSTOM_ZIP_LINK = "insert link here"

# Change the name of the custom archives. A new archive with the same name will not be downloaded.
CUSTOM_ARCHIVE_NAME = "custom_archive"

# Separator line for easier reading of notebook output.
DIVIDER = "─" * 200
4.9.4. Technische Vorbereitung#
Bevor die Videos analysiert werden können, müssen die benötigten Softwarepakete installiert, in das Notebook eingebunden und das vortrainierte Insightface-Modell geladen werden.
Installation der Programmbibliotheken#
Der folgende Codeblock installiert externe Programmbibliotheken, die nicht in der Standardinstallation von Python enthalten sind. Dazu zählen neben dem Modell Insightface zur Gesichtserkennung
pandaszum Bearbeiten und Exportieren von tabellarischen Daten,opencv-pythonzur Videobearbeitung,numpyzum wissenschaftliches Rechnen (Umgang mit Vektoren etc.)pympi-lingzum Schreiben von ELAN-Dateien (.eaf).tqdmfür die prozentuale Anzeige des Bearbeitungsfortschritts durch einen Balkentorchfür den Einsatz von Machine Learningonnxruntimebzwonnxruntime-gpuzur Ausführung von Machine-Learning-Modellen
Für die wichtigsten Bibliotheken wird eine spezifische Version installiert, um deren interdependente Funktionsweise zu garantieren.
Im Zuge der Installation der Bibliotheken wird automatisch ermittelt, ob eine Cuda-fähige GPU vorhanden ist und die die Installation entsprechend angepasst. Mit einer Cuda-fähigen GPU (Graphics Processing Unit) können Rechenoperationen wesentlich schneller ausgeführt werden als mit einer ‘normalen’ CPU (Central Processing Unit) und damit die Zeit für die Annotation einer Videodatei erheblich verkürzt werden. Zum genaueren Verständnis des Unterschieds von GPU und CPU empfehlen wir den OER-Abschnitt zu den technischen Grundlagen. Auf die Information, ob eine GPU oder eine CPU zur Verfügung steht wird später erneut Bezug genommen, um die jeweils geeigneten Modell-Pakete automatisch auszuwählen.
In einer lokalen und bei einer erneuten Ausführung des Notebooks identischen Arbeitsumgebung muss diese Zelle nicht bei jeder Sitzung nochmals ausgeführt werden. In Google Colab ist eine erneute Installation nach dem Neustart der Laufzeit hingegen notwendig, da alle speziell installierten Programmbibliotheken beim Beenden der Laufzeit gelöscht werden.
print("Installing dependencies.")
import sys

# Detect whether the notebook is running in Google Colab.
try:
    from google.colab import files
    colab = True
except ImportError:
    print("Using non-colab environment.")
    colab = False

# Check for an NVIDIA GPU on Windows or Unix-like systems.
if sys.platform.startswith("win"):
    # Suppress pip version checks.
    !pip -q config set global.disable-pip-version-check true > NUL 2>&1
    # Check whether the NVIDIA command-line utility is available.
    cuda = (os.system("nvidia-smi > NUL 2>&1") == 0)
else:
    # Suppress pip version checks.
    !pip -q config set global.disable-pip-version-check true > /dev/null 2>&1
    # Check whether the NVIDIA command-line utility is available.
    cuda = (os.system("nvidia-smi > /dev/null 2>&1") == 0)

# Install libraries for tables, images, EAF annotations, and progress displays.
!pip install -q pandas
!pip install -q opencv-python==4.13.0.92
!pip install -q numpy
!pip install -q pympi-ling==1.71
!pip install -q tqdm==4.68.3

# Track whether ONNX Runtime exposes a CUDA execution provider.
onnx_cuda_available = False
providers = []

if cuda:
    print("GPU detected. Installing GPU backend.")

    # Install GPU backend.
    if not colab:
        !pip install -q torch --index-url https://download.pytorch.org/whl/cu126

    !pip install -q "onnxruntime-gpu==1.22.0"

    # Check whether the installed ONNX Runtime lists the CUDA execution provider.
    try:
        import onnxruntime as ort
        providers = ort.get_available_providers()
        print(providers)
        onnx_cuda_available = "CUDAExecutionProvider" in providers

        if onnx_cuda_available:
            print("Using GPU backend.")
            !nvidia-smi --query-gpu=name --format=csv,noheader
            ort.preload_dlls(cuda=True, cudnn=True, msvc=True)

        else:
            print("CUDA provider unavailable. Falling back to CPU.")
            cuda = False

    except ImportError:
        cuda = False

# Fall back to CPU if no usable CUDA backend is available.
if not cuda:
    print("Using CPU backend.")

    # Install CPU backend.
    !pip install -q "onnxruntime==1.22.0"

# Install the pretrained face-analysis framework.
!pip install -q insightface==1.0.1
Installing dependencies.
Using non-colab environment.
Using CPU backend.
Import der Programmbibliotheken#
Durch den Import werden die installierten Funktionen nun in der aktuellen Notebook-Sitzung verfügbar. Die Bibliotheken übernehmen unterschiedliche Aufgaben, die im Codeblock jeweils kurz erläutert werden.
# Face detection and embedding extraction.
import insightface

# Working with tables, numerical arrays, and video/image data.
import pandas as pd
from pathlib import Path
import cv2
import numpy as np
# Measuring time and showing analysis progress.
import time
import datetime
from tqdm.notebook import tqdm
# Downloading and extracting input archives.
from urllib.request import urlretrieve
import zipfile
# Creating EAF annotations and displaying reference images.
import pympi
import warnings
from PIL import Image
from IPython.display import display
# Suppress future-deprecation warnings from dependencies.
warnings.filterwarnings("ignore", category=FutureWarning)
print("Dependencies imported.")
Dependencies imported.
Download des Analysematerials#
Zum Download des Testmaterials und eines eigenen .zip-Archivs wird eine wiederverwendbare Funktion definiert und direkt angewendet.
Falls bei der Festlegung der Parameter DOWNLOAD_TESTFILES = True gesetzt ist, lädt das Notebook das .zip-Archiv character_detection_testfiles.zip herunter, das einen Trailer zu dem Konrad Wolfs Film Der geteilte Himmel, entsprechende Referenzabbildungen zu den Figuren und eine csv-Datei mit den Einstellungs-Annotationen zum Trailer enthält. Diese werden für die Durchführung der Figurenerkennung und die Ausgabe der Annotations-Dateien benötigt. Liegt character_detection_testfiles.zip aufgrund einer vorherigen Ausführung bereits auf derselben Ordnerebene wie das Notebook, wird die Datei nicht erneut heruntergeladen. Anschließend wird ihr Inhalt in den zuvor festgelegten Videoordner entpackt. Zu Lernzwecken im Rahmen der OER empfehlen wir den Download und die Arbeit mit den Testdateien im Notebook.
Eigene Videodateien, Referenzabbildungen für die Erkennung der Figuren und gegebenenfalls Einstellungsannotationen müssen in eigenen Unterordnern innerhalb von VIDEO_PATH abgelegt werden. In diesem Fall muss DOWNLOAD_TESTFILES = False gesetzt werden. Für jedes Video muss ein eigener Unterordner angelegt werden, der die jeweilige Videodatei und die zugehörigen Referenzabbildungen enthält. Videodateien, die direkt im übergeordneten Ordner VIDEO_PATH liegen, werden bei der Analyse nicht berücksichtigt. Auch tiefer verschachtelte Unterordner werden nicht durchsucht. Außerdem kann mittels des Parameters CUSTOM_ZIP_LINK ein eigenes .zip-Archiv heruntergeladen werden, wie bereits eingangs im Kontext der Festlegung der Parameter erläutert. In beiden Fällen sollte der Codeblock zur Festlegung der Parameter bereits ausgeführt worden sein, um falls notwendig den Videoordner erst zu erstellen.
# Define a reusable function for downloading .zip archives.
# This function takes three arguments: The download link, the name for the downloaded archive, and the directory to unzip the archive into.
def download_zip(url: str, archive_name: str, target_directory: str):

    # Add .zip to the filename and turn it into a relative path in the working directory.
    archive_path = Path(f"{archive_name}.zip")

    # Download only if the archive is not already present in the working directory.
    if not archive_path.is_file():
        # Download the file.
        print(f"Downloading {archive_path}...")
        urlretrieve(url, archive_path)
        print(f"{archive_name} downloaded.")
    else:
        print(f"{archive_name} already downloaded.")

    # Unzip the file to the target_directory.
    target_directory = Path(target_directory)
    with zipfile.ZipFile(archive_path,"r") as zip_ref:
        zip_ref.extractall(target_directory)
        print(f"Extracted {archive_name} to {target_directory}.")

# Download and extract the testfiles if the setting is enabled.
if DOWNLOAD_TESTFILES == True:
    print("Testfile download requested.")

    # Download the testfiles
    url = ("https://owncloud.gwdg.de/index.php/s/C45WJA0iKdZ6uqn/download")
    download_zip(url, "character_detection_testfiles", VIDEO_PATH)
else:
     print("No testfile download requested.")

# Download and extract the custom archive if a link is provided.
if CUSTOM_ZIP_LINK != "insert link here":
    print("Custom file download requested.")

    # Download the custom video archive.
    download_zip(CUSTOM_ZIP_LINK, CUSTOM_ARCHIVE_NAME, VIDEO_PATH)
Testfile download requested.
Downloading character_detection_testfiles.zip...
character_detection_testfiles downloaded.
Extracted character_detection_testfiles to videos_characters.
Vorbereitung des InsightFace-Modells#
Je nachdem, ob eine CUDA-fähige GPU vorhanden ist, wird ein unterschiedliches vortrainiertes Modellpaket für die Gesichtsanalyse geladen. Beide Pakete enthalten Modelle zur Erkennung von Gesichtern im Bild (face detection) und zur Erstellung von Gesichts-Embeddings (face recognition). Wir verwenden das Modellpaket antelopev2 für die Ausführung auf einer GPU und buffalo_m für die Ausführung auf einer CPU. Beide liefern gute Ergebnisse bei der Gesichtserkennung. Wie InsightFace die unterschiedlichen Modelle zur Gesichtsanalyse in einem Modellpaket bündelt, erläutert der OER-Abschnitt InsightFace-Implementierung.
Da die beiden Modellpakete unterschiedliche vortrainierte Modelle enthalten, können sich ihre Erkennungsergebnisse unterscheiden. Für einen direkten Vergleich von Analyseergebnissen sollte möglichst dasselbe Modellpaket verwendet werden.
# Create the directory for storing pretrained model packages.
model_path = ".insightface"
os.makedirs(model_path, exist_ok=True)

# Select separate model packages for GPU and CPU processing.
gpu_model = "antelopev2"
cpu_model = "buffalo_m"

# Download and prepare antelopev2 on CUDA-enabled GPUs.
if cuda:
    url = "https://github.com/deepinsight/insightface/releases/download/v0.7/antelopev2.zip"
    download_zip(url, "antelopev2", f"{model_path}/models")
    model = insightface.app.FaceAnalysis(
        name = gpu_model,
        root = f"{model_path}",
        providers = ['CUDAExecutionProvider']
    )
    # Prepare the model with the configured detection threshold and input resolution.
    model.prepare(ctx_id=0, det_thresh=FACE_DETECTION_THRESHOLD, det_size=(640, 640))
    print("Using GPU for InsightFace")
    applied_model = gpu_model

# Download and prepare buffalo_m for CPU processing.
else:
    url = "https://github.com/deepinsight/insightface/releases/download/v0.7/buffalo_m.zip"
    download_zip(url, "buffalo_m", f"{model_path}/models")
    model = insightface.app.FaceAnalysis(
        name = cpu_model,
        root = model_path,
        providers = ['CPUExecutionProvider']
    )
    # Prepare CPU inference with the same detection settings.
    model.prepare(ctx_id=-1, det_thresh=FACE_DETECTION_THRESHOLD, det_size=(640, 640))
    print("Using CPU for InsightFace")
    applied_model = cpu_model
print(f"with model {applied_model}.")
Downloading buffalo_m.zip...
buffalo_m downloaded.
Extracted buffalo_m to .insightface/models.
Applied providers: ['CPUExecutionProvider'], with options: {'CPUExecutionProvider': {}}
find model: .insightface/models/buffalo_m/1k3d68.onnx landmark_3d_68 ['None', 3, 192, 192] 0.0 1.0
Applied providers: ['CPUExecutionProvider'], with options: {'CPUExecutionProvider': {}}
find model: .insightface/models/buffalo_m/2d106det.onnx landmark_2d_106 ['None', 3, 192, 192] 0.0 1.0
Applied providers: ['CPUExecutionProvider'], with options: {'CPUExecutionProvider': {}}
find model: .insightface/models/buffalo_m/det_2.5g.onnx detection [1, 3, '?', '?'] 127.5 128.0
Applied providers: ['CPUExecutionProvider'], with options: {'CPUExecutionProvider': {}}
find model: .insightface/models/buffalo_m/genderage.onnx genderage ['None', 3, 96, 96] 0.0 1.0
Applied providers: ['CPUExecutionProvider'], with options: {'CPUExecutionProvider': {}}
find model: .insightface/models/buffalo_m/w600k_r50.onnx recognition ['None', 3, 112, 112] 127.5 127.5
set det-size: (640, 640)
Using CPU for InsightFace
with model buffalo_m.
Definition der Hilfsfunktionen#
Um eine Wiederholung von identischem Code zu vermeiden, wird einmalig die Funktion insightface_embed definiert, welche die Gesichtserkennung (Detection) und die Erstellung der Embeddings (Representation) in sich vereint. Außerdem wird auch eine Option zur Visualisierung der Face-Detection eingebunden. Ein Embedding stellt ein Gesicht als Vektor dar, also als eine bestimmte Liste von Zahlen. Diese Vektoren erfassen dabei die spezifischen Merkmale eines Gesichts, also was es von anderen Gesichtern unterscheidet. Während der Gesichtserkennung wird zudem ein Konfidenzwert ausgegeben der angibt, mit welcher Wahrscheinlichkeit es sich tatsächlich um ein Gesicht handelt. Der Parameter FACE_DETECTION_THRESHOLD kommt hier zum Einsatz um festzulegen, ab welchem Konfidenzwert ein Gesicht als erkannt gilt und die Erkennung für die weitere Verarbeitung gespeichert wird.
# Extract normalised face embeddings and an optional visualisation from an image.
def insightface_embed(
    model, # The previously prepared model
    image: np.ndarray, # The image or frame
    conf_thresh: float = 0.75, # Minimum face-detection confidence
    create_visualisation: bool = False
    ):

    # Raise an error if the image is corrupted.
    if image is None:
        raise FileNotFoundError(f"Could not read image")

    # Detect faces and obtain their embedding representations.
    faces = model.get(image)


    embeddings = []
    face_metadata = []
    confirmed_faces = []
    # Keep only faces that meet the confidence threshold.
    for i, face in enumerate(faces):
        # Save the embeddings and metadata if the detection confidence score is higher than the confidence threshold.
        if face.det_score >= conf_thresh:
            embeddings.append(face.normed_embedding)
            face_metadata.append({
                "face_idx": i, # The assigned number of the face in the frame. This could be used to label faces within visualisations.
                "bbox": face.bbox, # The bounding box of the detected face
                "score": float(face.det_score) # The confidence score with which the face has been detected.
            })
            confirmed_faces.append(face)

    # Optionally draw the accepted faces for inspection.
    if create_visualisation:
        visualisation = model.draw_on(image, confirmed_faces)
    else:
        visualisation = None

    # Return an empty array if no face passes the detection threshold.
    if len(embeddings) == 0:
        return np.zeros((0, 512), dtype=np.float32), [], None

    # Stack the embeddings in a numpy array.
    embeddings = np.stack(embeddings).astype(np.float32)

    # Return the embeddings, detection metadata, and optional visualisation.
    return embeddings, face_metadata, visualisation

print("Defined helper function.")
Defined helper function.
4.9.5. Automatische Figurenerkennung#
Erfassung der Analysematerialen und technischen Videometadaten#
Nun kann die eigentliche Figurenerkennung beginnen.
Für jeden Unterordner wird jeweils eine Videodatei und gegebenenfalls eine .csv-Datei mit Einstellungsannotationen berücksichtigt. Falls mehrere Videodateien oder mehrere passende Einstellungs-CSV-Dateien im gleichen Ordner gefunden werden, wird jeweils nur die zuerst eingelesene Datei verwendet. Die übrigen Dateien werden ignoriert und eine entsprechende Meldung ausgegeben. Da die Reihenfolge beim Einlesen nicht festgelegt ist, sollte jeder Unterordner nur eine Videodatei und höchstens eine Einstellungs-CSV-Datei enthalten.
Der Video-Ordner wird im nächsten Schritt nach Videodateien, Bilddateien mit Abbildungen der Figuren und .csv-Dateien mit Einstellungsannotationen durchsucht. Die Dateipfade sowie die Einstellungen pro Film werden in ein Dictionary übertragen. Ein Dictionary ist eine Python-Datenstruktur, in der jedem Schlüssel (key) ein Wert zugeordnet wird. Im vorliegenden Fall dient der Name eines Videos als Schlüssel. Der zugehörige Wert ist ein weiteres Dictionary, das den Dateipfad, die Figurenabbildungen und die Einstellungsdaten enthält. Weitere Informationen und Beispiele zur Funktionsweise eines Dictionaries finden Sie etwa im Dictionary-Kapitel des hier verlinkten Python Kurses.
# Register the material from each direct input subdirectory.
videos = {}
for folder in Path(VIDEO_PATH).iterdir():
    # Ignore files and Jupyter checkpoint folders.
    if not folder.is_dir() or "ipynb" in folder.name:
        continue
    # Use the input folder name to identify this video throughout the analysis.
    video_name = folder.name
    print(f"Opening folder {video_name}.")

    # Store the files belonging to each video in a nested dictionary.
    videos[video_name] = {}
    videos[video_name]["image_files"] = []
    videos[video_name]["video_path"] = None
    videos[video_name]["shots_csv"] = []

    # Collect reference images, one video file, and an optional shots CSV.
    for file in folder.iterdir():
        if file.name.lower().endswith(('.png', '.jpg', '.jpeg', '.tiff', '.bmp', '.gif')):
            print(f"Found image {file.name}.")
            videos[video_name]["image_files"].append(file)

        elif file.name.lower().endswith(('.mp4', '.avi', '.mov', '.mkv', '.wmv',
                                          '.flv', '.webm', '.mpeg', '.mpg', '.m4v', '.3gp')):

            print(f"Found video {file.name}.")
            # Only the first video encountered in a folder is used.
            if not videos[video_name]["video_path"]:
                videos[video_name]["video_path"] = file
            else:
                print(F"More than one video file in folder {video_name}."
                      F"Video {file.name} will not be analysed.")

        elif "_shots" in file.name.lower() and file.name.lower().endswith(".csv"):

            print(f"Found shots file {file.name}.")
            # Only the first matching shots CSV is used.
            if not videos[video_name]["shots_csv"]:
                videos[video_name]["shots_csv"] = file
                shots_csv_found = False
            else:
                print(F"More than one shots.csv in folder {video_name}."
                      F"{file.name} will not be used.")

    # Report missing input files.
    if not videos[video_name]["image_files"]:
        print(f"⚠ No image files found in folder {video_name}, analysis cannot proceed.")
    if not videos[video_name]["video_path"]:
        print (f" ⚠ No video files found in folder {video_name}, analysis cannot proceed.")

    print(DIVIDER)
Opening folder Der geteilte Himmel_Trailer_1964.
Found video Der geteilte Himmel_Trailer_1964.mp4.
Found image Rita04.png.
Found image Rita01.png.
Found image Rita03.png.
Found image Rita02.png.
Found image Manfred04.png.
Found shots file Der geteilte Himmel_Trailer_1964_shots_0.5.csv.
Found image Manfred02.png.
Found image Manfred03.png.
Found image Manfred01.png.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Erstellung und Prüfung der Referenz-Embeddings#
Mittels der zuvor definierten Funktion werden anhand der Dateien mit den Abbildungen der Figuren (meist Screenshots) Vergleichs-Embeddings zu den Figuren erstellt. Ist exakt ein Gesicht im Bild erkannt wird das Embedding übernommen und die Gesichtserkennung visualisiert.
Pro Figur kann eine beliebige Anzahl an Abbildungen verwendet werden, aus denen ein durchschnittliches Embedding berechnet wird. Die Namen der Figuren werden den Dateinamen entnommen. Die Namen der Figuren werden aus den Dateinamen der Referenzbilder ermittelt. Dabei entfernt das Notebook die letzten beiden Zeichen vor der Dateiendung. Referenzbilder müssen daher beispielsweise Rita_1.jpg, Rita_2.jpg und Ralph_1.png heißen. So können mehrere Bilder derselben Figur zugeordnet werden.
Zur Erstellung der Vergleichs-Embeddings werden die Referenzbilder mit der zuvor definierten Funktion insightface_embed() analysiert. Dabei wird unabhängig vom allgemeinen Parameter FACE_DETECTION_THRESHOLD ein Schwellwert von 0.6 verwendet. Nur Referenzbilder, in denen genau ein Gesicht erkannt wird, werden berücksichtigt.
Liegen mehrere geeignete Referenzbilder einer Figur vor, wird aus deren Embeddings ein durchschnittlicher Vektor berechnet. Dieser wird anschließend normiert, sodass seine Länge wieder 1 beträgt, wie die übrigen Embeddings. Für jede Figur entsteht somit ein einzelnes Vergleichs-Embedding, das bei der späteren Analyse des Videomaterials verwendet wird.
Abschließend werden die Vergleichs-Embeddings verschiedener Figuren über das Skalarprodukt miteinander verglichen. Da die Embeddings normiert sind, entspricht das Skalarprodukt der Ähnlichkeit. Ein höherer Wert bedeutet eine größere Ähnlichkeit zwischen den Embeddings. Der Vergleich eines Embeddings mit sich selbst sollte einen Wert von ungefähr 1 ergeben.
# Prepare one comparison embedding per character in each video folder.
for video_name, video in videos.items():
    print(f"Opening folder {video_name}.")
    video["char_embeddings"] = {}
    for image in video["image_files"]:

        print(image)

        # Remove the final two characters of the filename stem to obtain the character name.
        char_name = image.stem[:-2]

        video["char_embeddings"].setdefault(char_name, [])

        print(f"Creating embedding for {char_name} using {image.name}.")

        image_cv2 = cv2.imread(str(image))
        # Use a stricter detection threshold for reference images than for video frames.
        embeddings, face_metadata, visualisation = insightface_embed(model, image_cv2, 0.6, True)
        n_embeddings = len(embeddings)
        if n_embeddings == 0:
            print(f"Image {image.name} does not provide a detectable face. Choose a different file.")
        elif n_embeddings > 1:
            print(f"Image {image.name} includes too many faces. Choose a different file.")
        # Accept a reference image only if exactly one face was detected.
        elif n_embeddings == 1:
            video["char_embeddings"][char_name].append(embeddings[0])
            print(f"Image {image.name} is perfect! The embedding was saved for future comparison.")
            display(Image.fromarray(cv2.cvtColor(visualisation, cv2.COLOR_BGR2RGB)))

    # Average and normalise the valid reference embeddings for each character.
    char_names = []
    for char_name, embeddings in video["char_embeddings"].items():
        print(char_name)
        char_names.append(char_name)

        embeddings = np.array(embeddings)
        avg_embed = np.mean(embeddings, axis=0)
        # Normalize the averaged embedding to unit length.
        norm = np.linalg.norm(avg_embed)
        if norm > 0:
            avg_embed = avg_embed / norm

        video["char_embeddings"][char_name] = avg_embed

    # Compare character embeddings and their self-similarity as a check.
    for i in range(len(char_names)):
        for j in range(i + 1, len(char_names)):
            name1 = char_names[i]
            name2 = char_names[j]

            emb1 = video["char_embeddings"][name1]
            emb2 = video["char_embeddings"][name2]

            sim1 = np.dot(emb1, emb2)
            sim2 = np.dot(emb1, emb1)
            sim3 = np.dot(emb2, emb2)

            print(f"{name1} vs {name2}: {sim1:.4f}")
            print(f"{name1} vs {name1}: {sim2:.4f}")
            print(f"{name2} vs {name2}: {sim3:.4f}")

    print(DIVIDER)
Opening folder Der geteilte Himmel_Trailer_1964.
videos_characters/Der geteilte Himmel_Trailer_1964/Rita04.png
Creating embedding for Rita using Rita04.png.
Image Rita04.png is perfect! The embedding was saved for future comparison.
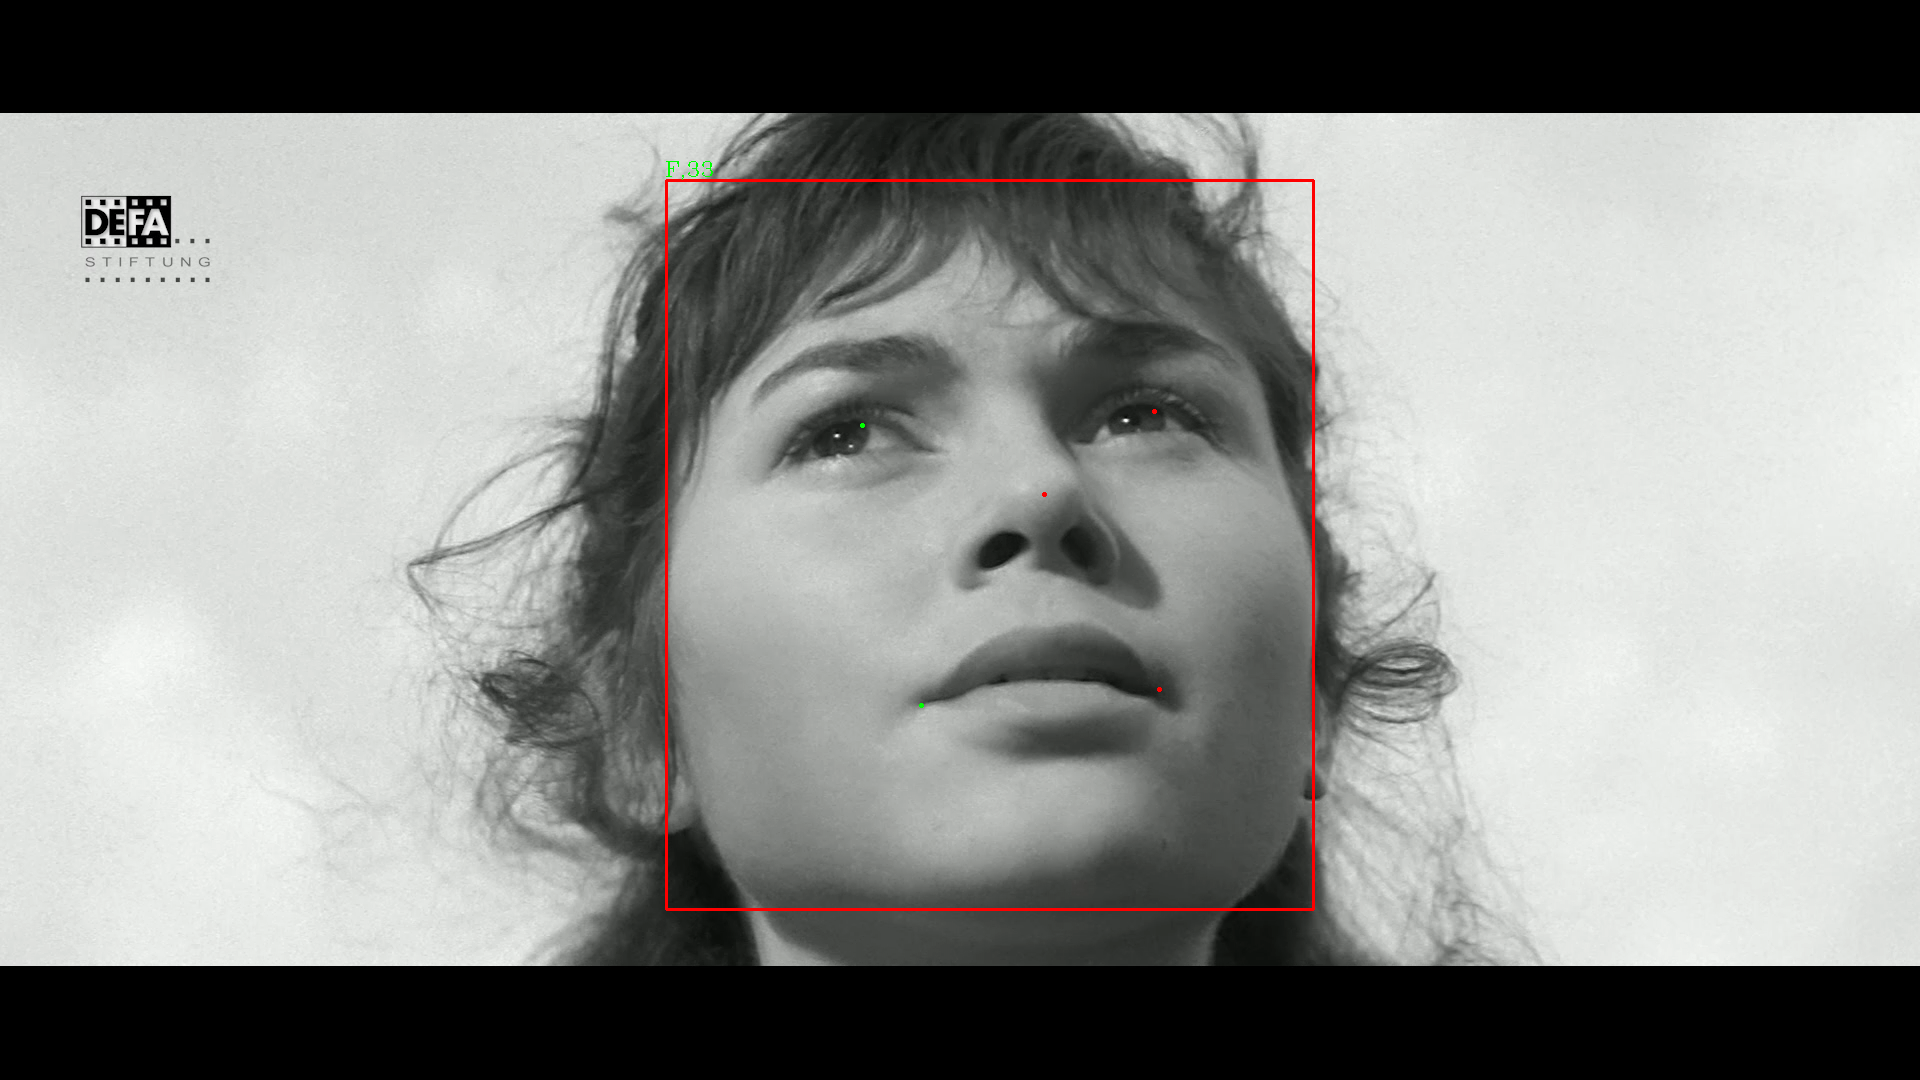
videos_characters/Der geteilte Himmel_Trailer_1964/Rita01.png
Creating embedding for Rita using Rita01.png.
Image Rita01.png is perfect! The embedding was saved for future comparison.
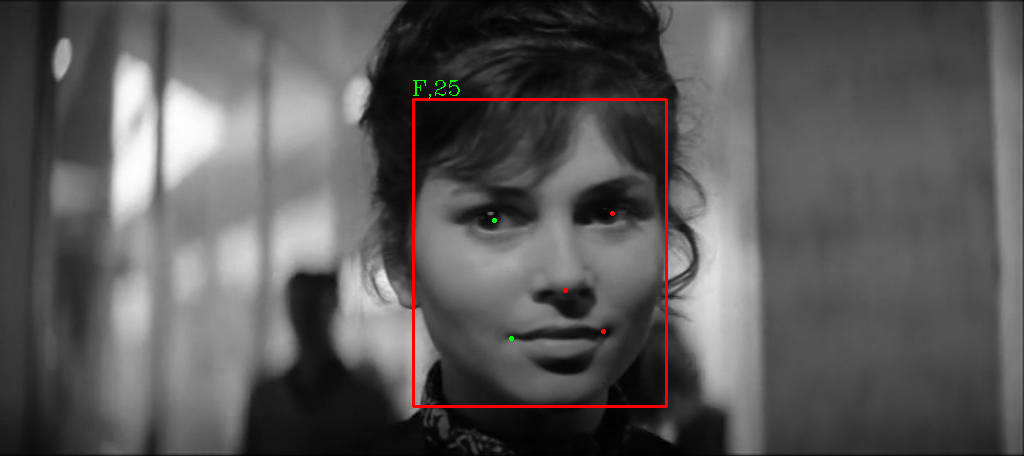
videos_characters/Der geteilte Himmel_Trailer_1964/Rita03.png
Creating embedding for Rita using Rita03.png.
Image Rita03.png is perfect! The embedding was saved for future comparison.
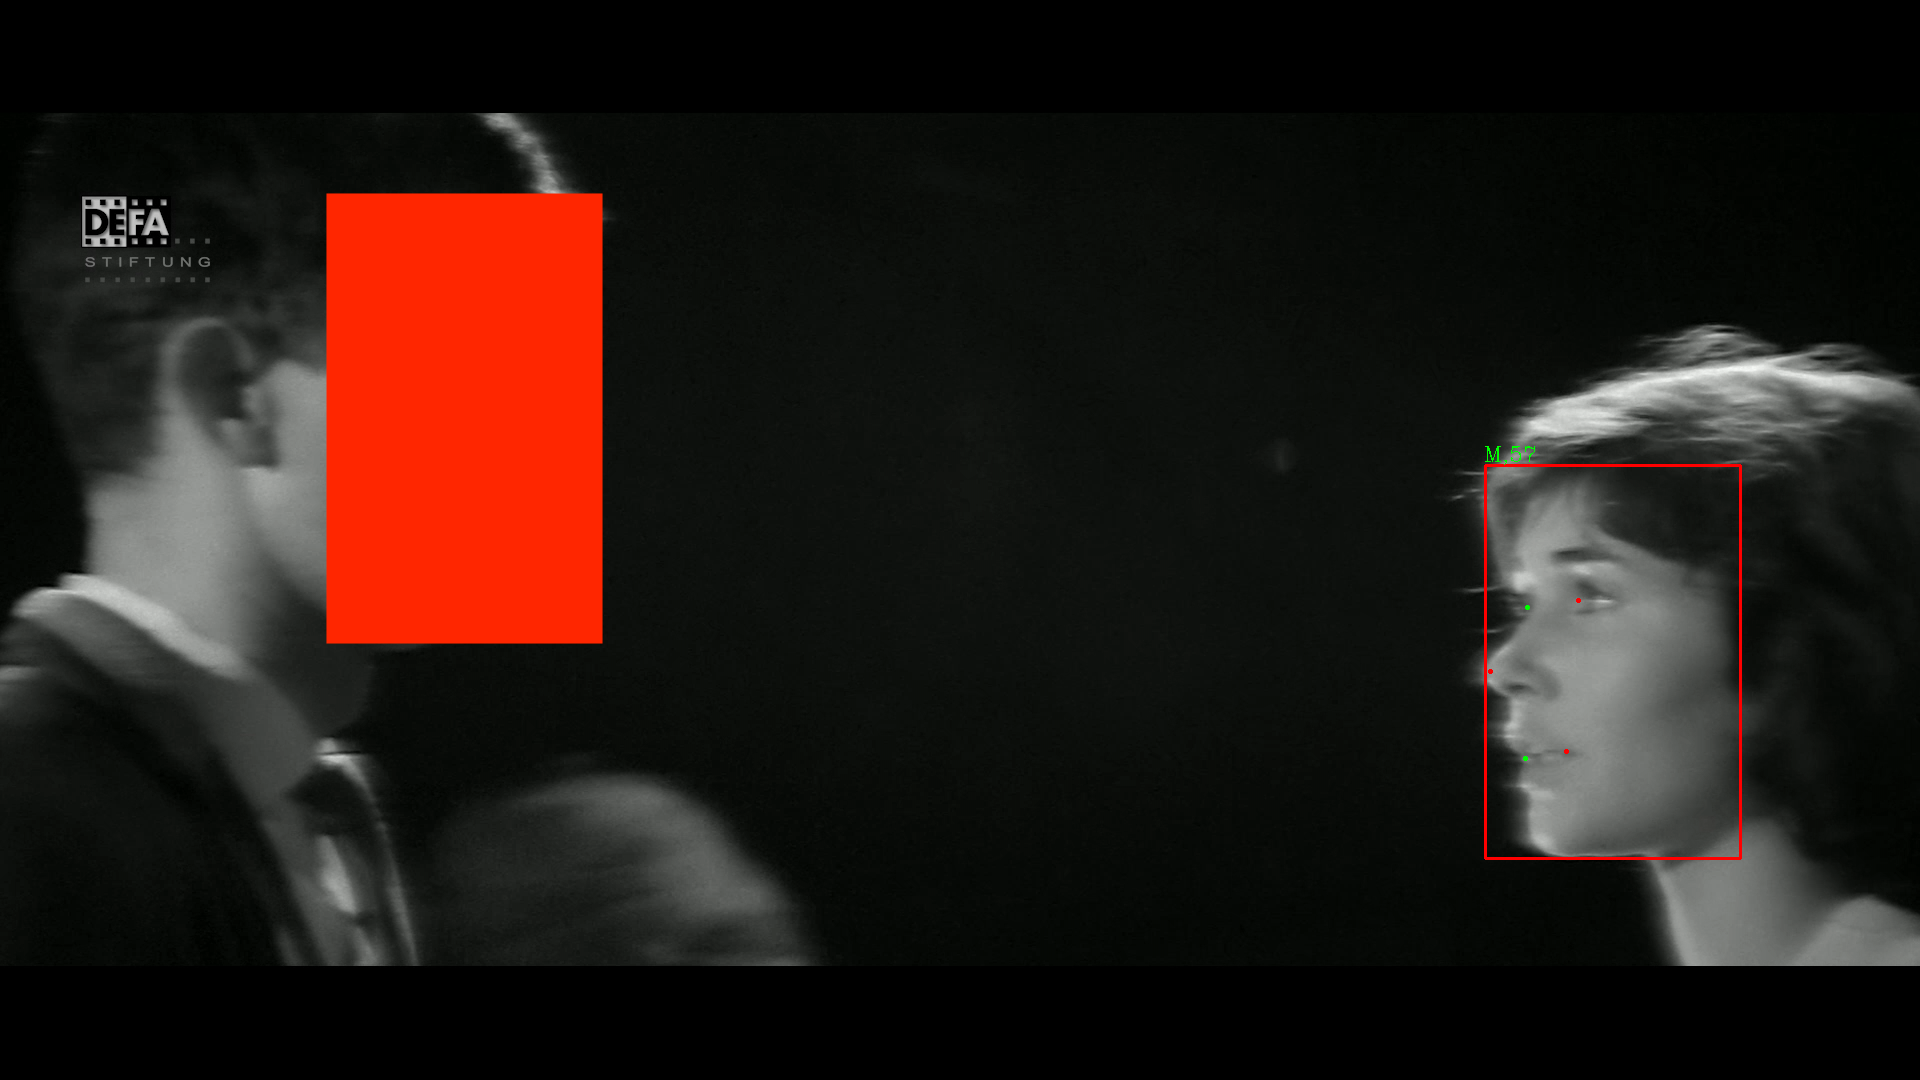
videos_characters/Der geteilte Himmel_Trailer_1964/Rita02.png
Creating embedding for Rita using Rita02.png.
Image Rita02.png does not provide a detectable face. Choose a different file.
videos_characters/Der geteilte Himmel_Trailer_1964/Manfred04.png
Creating embedding for Manfred using Manfred04.png.
Image Manfred04.png is perfect! The embedding was saved for future comparison.
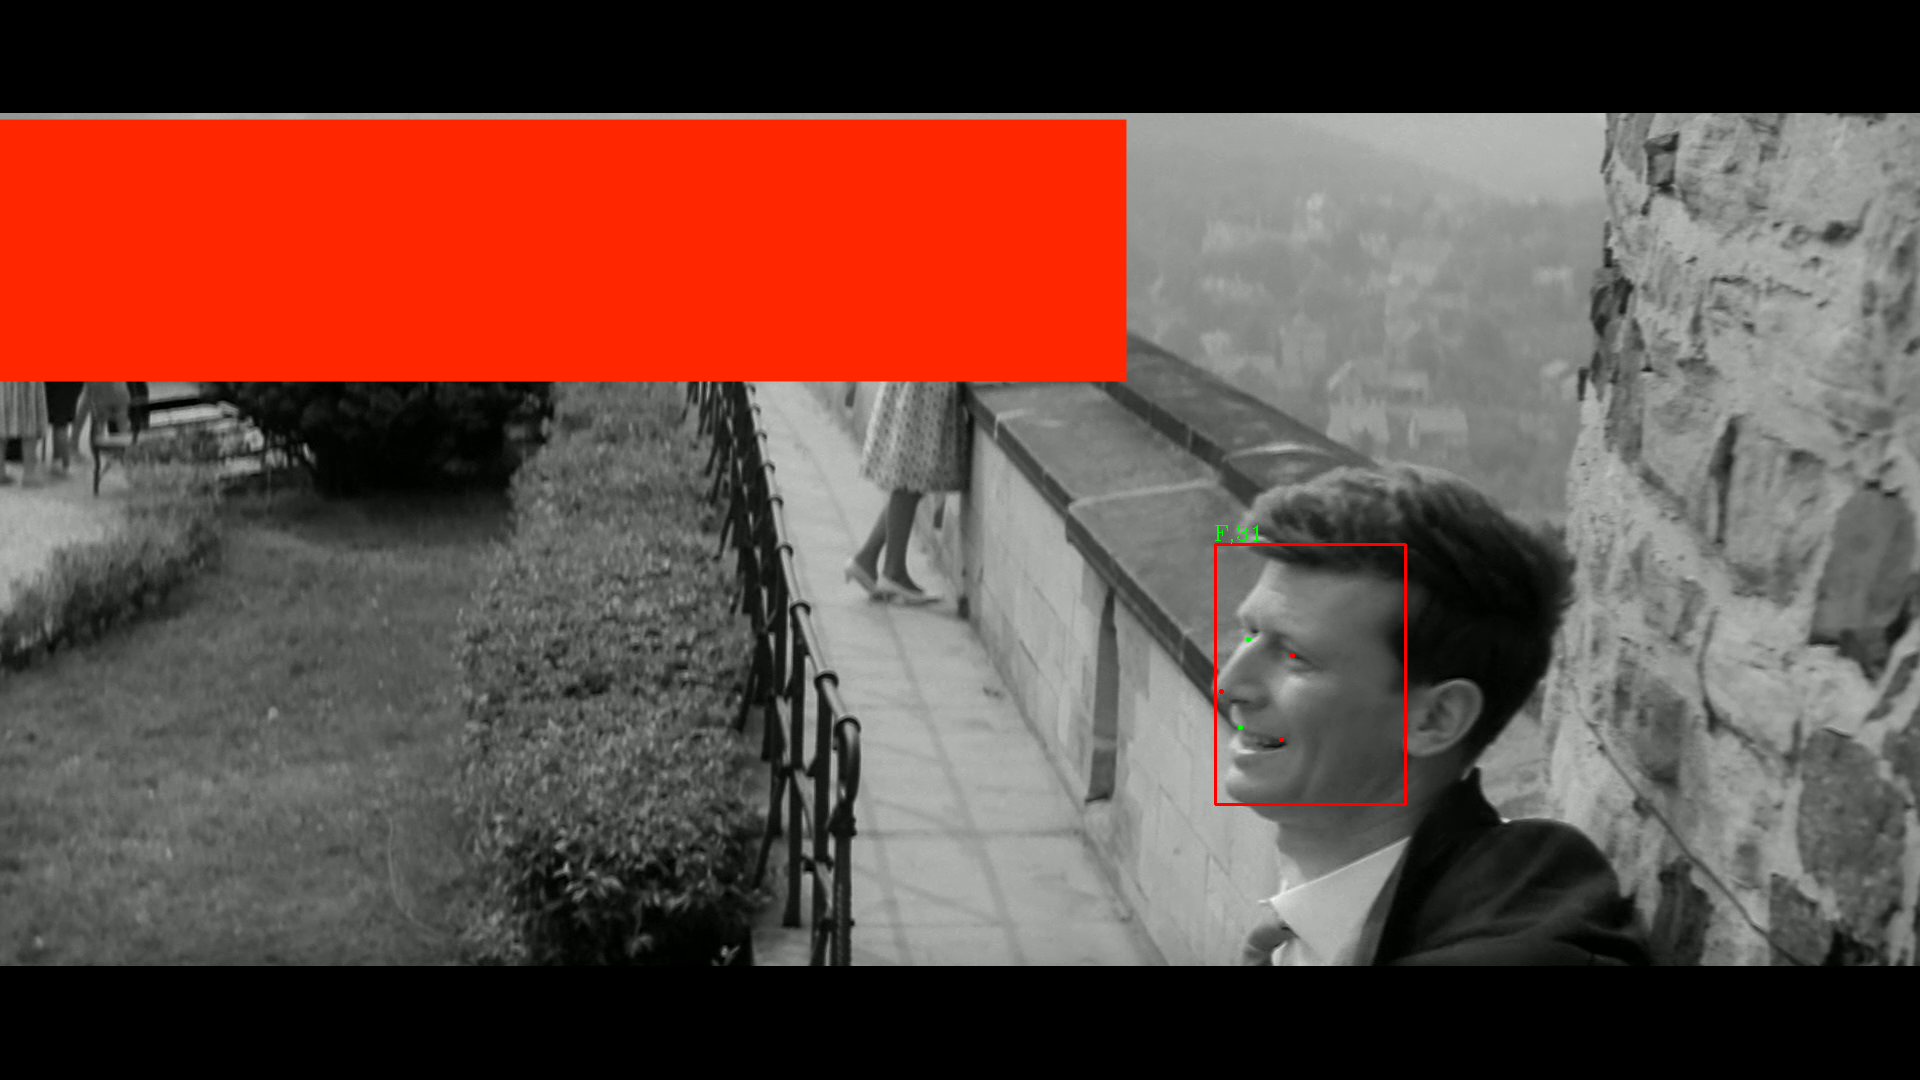
videos_characters/Der geteilte Himmel_Trailer_1964/Manfred02.png
Creating embedding for Manfred using Manfred02.png.
Image Manfred02.png is perfect! The embedding was saved for future comparison.
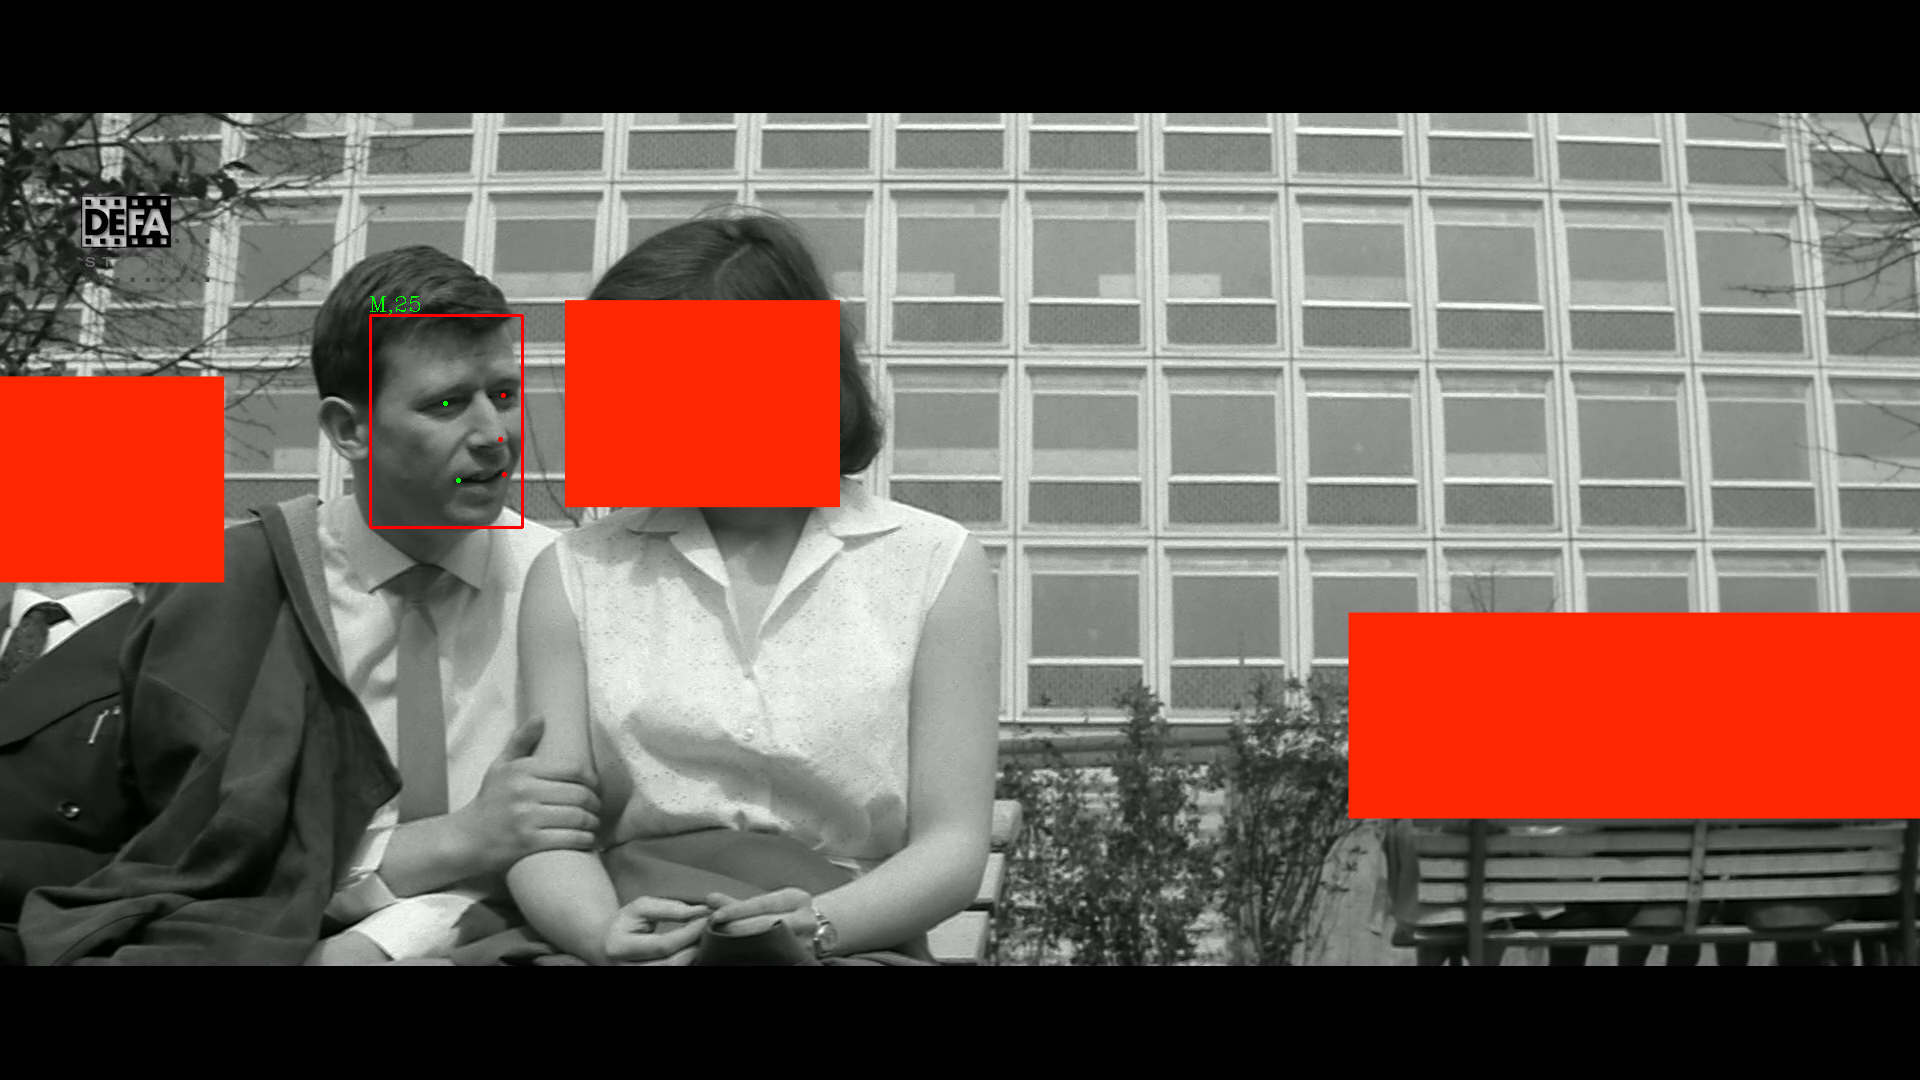
videos_characters/Der geteilte Himmel_Trailer_1964/Manfred03.png
Creating embedding for Manfred using Manfred03.png.
Image Manfred03.png is perfect! The embedding was saved for future comparison.
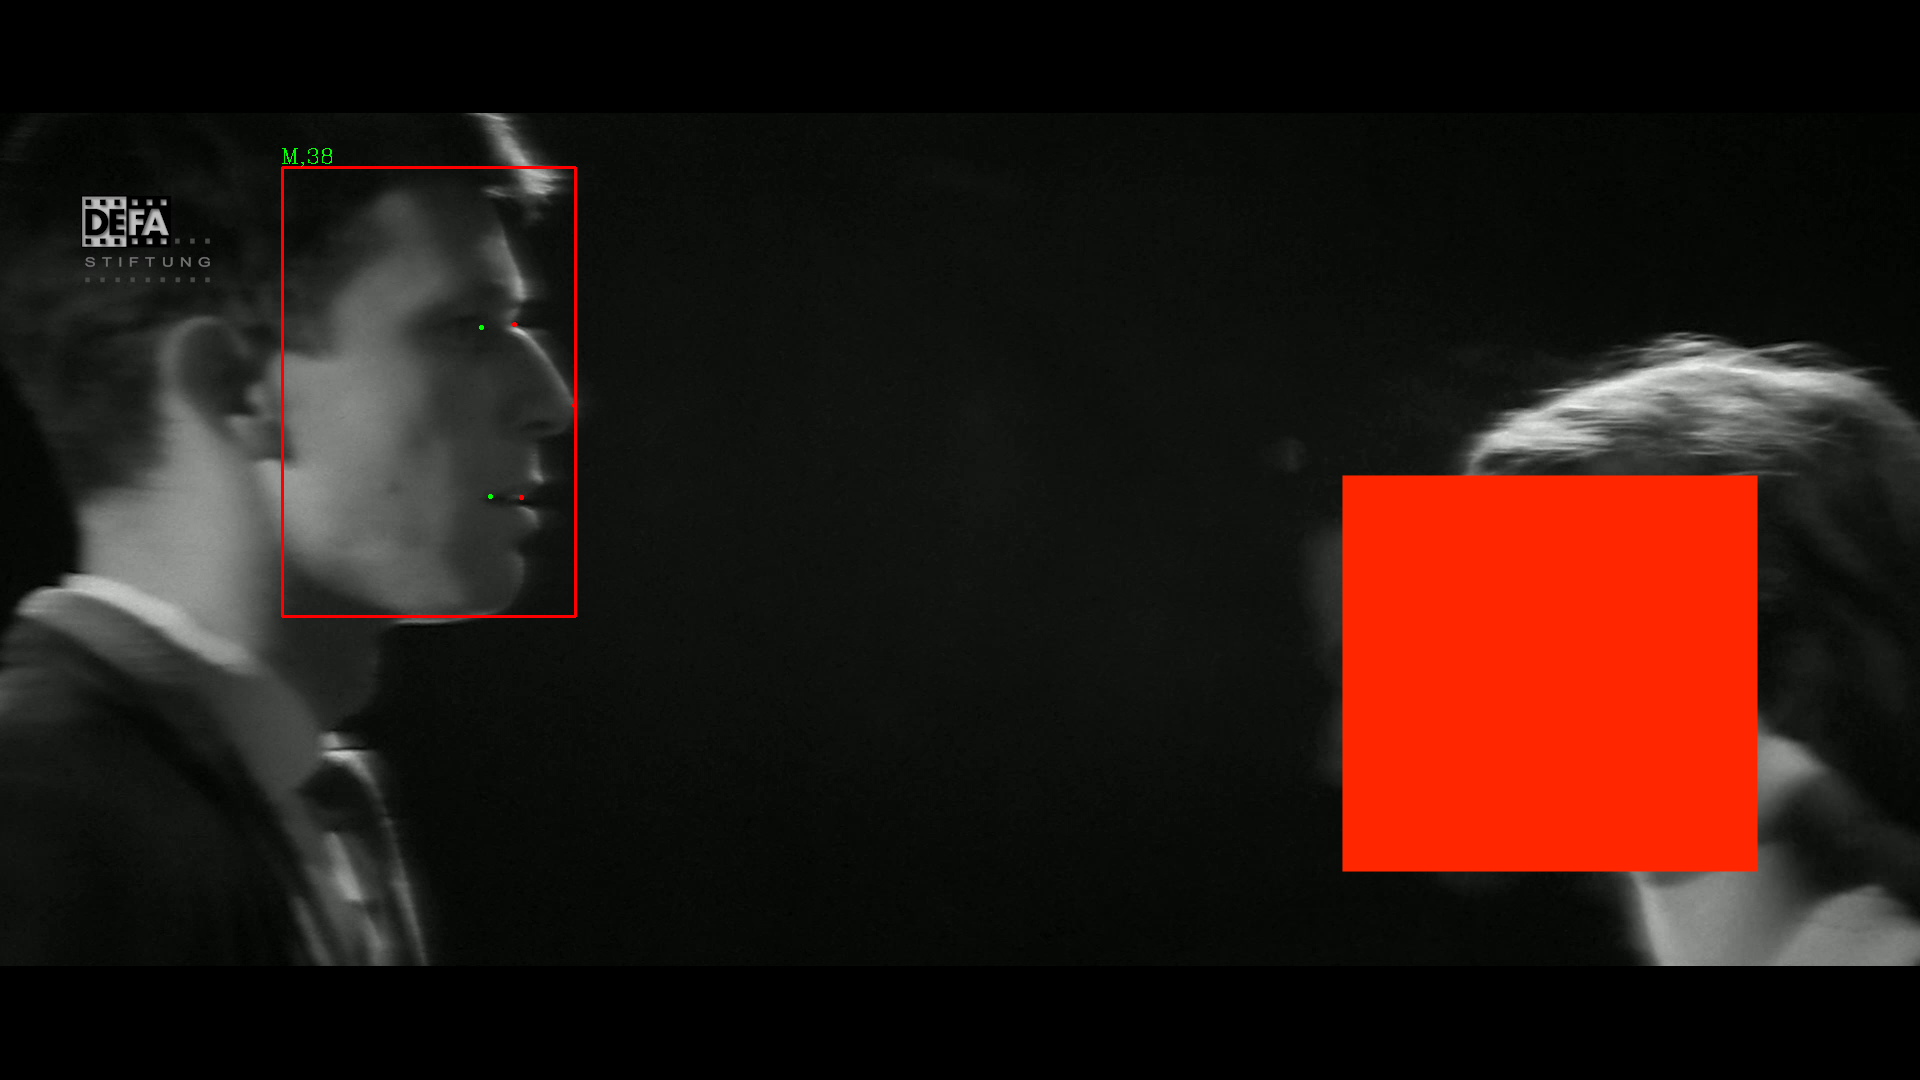
videos_characters/Der geteilte Himmel_Trailer_1964/Manfred01.png
Creating embedding for Manfred using Manfred01.png.
Image Manfred01.png does not provide a detectable face. Choose a different file.
Rita
Manfred
Rita vs Manfred: 0.0509
Rita vs Rita: 1.0000
Manfred vs Manfred: 1.0000
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Anwendung des Modells#
Nun wird die eigentliche Analyse der Videodateien ausgeführt. Zunächst werden anhand des Parameters SKIP_FRAMES die zu analysierenden Frames aus der Videodatei ausgewählt (siehe auch Abschnitt zu Festlegung der Parameter). Der Wert von SKIP_FRAMES legt fest, wie viele Frames nach der Auswertung eines Frames übersprungen werden. Eine Auswertung aller Frames einer Videodatei wäre in der Regel zu zeitintensiv, würde also sehr lange dauern. Wird ein hoher Wert für SKIP_FRAMES gewählt, kann jedoch die Genauigkeit der Analyse sinken, da Frames die die zu erkennenden Figuren beieinhalten evtl. übersprungen werden.
Auf die ausgewählten Frames wird anschließend die zuvor definierte Funktion insightface_embed() angewendet. Der durch FACE_DETECTION_THRESHOLD festgelegte Schwellwert bestimmt dabei, ab welchem Konfidenzwert (detection confidence score) ein Gesicht als erkannt gilt und weiterverarbeitet wird. Der Konfidenzwert beschreibt die Sicherheit der Modellvorhersage, dass es sich um ein Gesicht handelt.
Für jedes erkannte Gesicht wird ein Embedding erstellt und im Schritt der Figurenerkennung (Recognition) über das Skalarprodukt mit allen zuvor erstellten Vergleichs-Embeddings der Figuren verglichen. Anschließend wird die Figur mit dem höchsten Ähnlichkeitswert ausgewählt. Nur wenn dieser Wert den durch CHARACTER_RECOGNITION_THRESHOLD festgelegten Schwellwert erreicht oder überschreitet, wird das Gesicht der entsprechenden Figur zugeordnet. Andernfalls wird die Erkennung verworfen. Jedes erkannte Gesicht kann dabei nur einer Figur zugeordnet werden.
Für jede erfolgreiche Zuordnung werden die Position und der Zeitpunkt des Frames, der Ähnlichkeitswert sowie der Konfidenzwert der Gesichtsdetektion im zuvor erstellten Dictionary gespeichert.
Dieser Schritt ist sehr rechenintensiv. Je nach Videomaterial kann er von einer halben Stunde bis zu mehreren Stunden in Anspruch nehmen.
# Detect and identify faces in selected frames of each video.
for video_name, video in videos.items():
    print(f"Opening video {video_name}.")

    video_path =  video["video_path"]

    print(f"Analysing video {video_path.name}.")

    # Open the video and read its technical properties.
    cap = cv2.VideoCapture(str(video_path))

    if not cap.isOpened():
        print(f"Could not open video {video.name}")
        continue

    frame_rate = cap.get(cv2.CAP_PROP_FPS)
    frame_count = int(cap.get(cv2.CAP_PROP_FRAME_COUNT))
    frame_height = int(cap.get(cv2.CAP_PROP_FRAME_HEIGHT))
    frame_width = int(cap.get(cv2.CAP_PROP_FRAME_WIDTH))

    # Extract an optional release year from the final filename segment.
    try:
        video_title, release_year = video_path.stem.rsplit("_", 1)
        release_year = int(release_year)
    except ValueError:
        video_title = video_path.stem
        release_year = None

    # Express the full video duration as hours, minutes, and seconds.
    duration_hh_mm_ss = str(datetime.timedelta(seconds=round(frame_count / frame_rate))) if frame_rate > 0 else None

    # Select regularly spaced frames according to SKIP_FRAMES.
    selected_frames = range(0, frame_count, 1 + int(SKIP_FRAMES))

    video["char_frames"] = {}
    # Record the video properties and parameters used in the analysis.
    video["metadata"] = {
        "video_name"                      : video_path.name,
        "title"                           : video_title,
        "release_year"                    : release_year,
        "frame_count"                     : frame_count,
        "frame_height"                    : frame_height,
        "frame_width"                     : frame_width,
        "frame_rate"                      : frame_rate,
        "duration_hh_mm_ss"               : duration_hh_mm_ss,
        "model"                           : applied_model,
        "device"                          : "cuda" if cuda else "cpu",
        "analysis_timestamp"              : datetime.datetime.now(datetime.timezone.utc).isoformat(timespec="seconds"),
        "processing_time_hh_mm_ss"         : None,  # Updated after the analysis.
        "face_detection_threshold"        : FACE_DETECTION_THRESHOLD,
        "character_recognition_threshold" : CHARACTER_RECOGNITION_THRESHOLD,
        "skip_frames"                     : SKIP_FRAMES,
        "selected_frames"                 : len(selected_frames),
        "tolerance_frames"                : TOLERANCE_FRAMES
    }

    print(f"Total frames: {frame_count}")
    print(f"Selected {len(selected_frames)} frames with SKIP_FRAMES = {int(SKIP_FRAMES)}.")

    # Start measuring the analysis time.
    start_time = time.perf_counter()

    # Use a set for efficient membership checks when reading frames.
    selected_set = set(selected_frames)

    for frame_idx in tqdm(range(frame_count), total=frame_count):

        # Read the next frame, even when it is skipped during analysis.
        ret_boolean, frame = cap.read()
        if not ret_boolean:
                break

        if frame_idx not in selected_set:
            continue

        # Convert the frame position to seconds.
        time_s = frame_idx / frame_rate

        # Detect faces and obtain embeddings for the selected frame.
        embeddings, face_metadata, _ = insightface_embed(model, frame, float(FACE_DETECTION_THRESHOLD), False)

        if len(embeddings) > 0:
            for e, embed in enumerate(embeddings):
                # Find the reference embedding with the highest similarity.
                best_char = None
                best_dot = -1
                for char_name, char in video["char_embeddings"].items():

                    dot = np.dot(char, embed)

                    if dot > best_dot:
                        best_dot = dot
                        best_char = char_name

                # Save the detection only if it meets the recognition threshold.
                if best_dot >= float(CHARACTER_RECOGNITION_THRESHOLD):
                    video["char_frames"].setdefault(best_char, {})[frame_idx] = {
                        "time_s": time_s,
                        "time_hh_mm_ss": str(datetime.timedelta(seconds=round(time_s))),
                        "dot": best_dot,
                        "score": face_metadata[e]["score"]
                    }

        del embeddings, face_metadata

    # Release the video and record the elapsed processing time.
    cap.release()

    processing_time_seconds = time.perf_counter() - start_time
    elapsed_time_hh_mm_ss = str(datetime.timedelta(seconds=round(processing_time_seconds)))
    video["metadata"]["processing_time_hh_mm_ss"] = elapsed_time_hh_mm_ss

    print(f"Analysis took {elapsed_time_hh_mm_ss} for video {video_path.name}.")
    print(DIVIDER)

print(DIVIDER)
Opening video Der geteilte Himmel_Trailer_1964.
Analysing video Der geteilte Himmel_Trailer_1964.mp4.
Total frames: 5225
Selected 1045 frames with SKIP_FRAMES = 4.
Analysis took 0:08:28 for video Der geteilte Himmel_Trailer_1964.mp4.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Tabellarische Aufbereitung der Gesichtserkennung#
Die zuvor erstellten Dictionaries mit den einzelnen Erkennungsergebnissen werden in pandas-DataFrames überführt. Ein DataFrame ist eine tabellarische Datenstruktur, die sich besonders für die weitere Verarbeitung und den Export der Analyseergebnisse eignet. Für jede erkannte Figur wird eine Tabelle erstellt, in der jeder Eintrag einem Frame entspricht, in dem die Figur erkannt wurde. Gespeichert werden der Zeitpunkt des Frames, der Figurenname, der Ähnlichkeitswert der Embeddings und der Konfidenzwert der Gesichtsdetektion.
Aus diesen Daten werden anschließend verschiedene Metadaten berechnet. Für jede erkannte Figur werden folgende Werte erfasst:
die Anzahl der Frames, in denen die Figur erkannt wurde (
detected_frames),das durchschnittliche Skalarprodukt der erkannten Gesichter mit dem Vergleichs-Embedding der Figur (
dot_mean),der durchschnittliche Konfidenzwert der Gesichtsdetektion (
score_mean),die geschätzte Auftrittsdauer der Figur in Sekunden (
time_sum_s),und die geschätzte Auftrittsdauer im Format Stunden:Minuten:Sekunden (
time_sum_hh_mm_ss).
Zusätzlich werden allgemeine Metadaten zum Video und zur Durchführung der Analyse gespeichert:
der Dateiname (
video_name), der Filmtitel (title) und gegebenenfalls das aus dem Dateinamen ermittelte Erscheinungsjahr (release_year),die Gesamtanzahl der Frames (
frame_count), die Auflösung (frame_width,frame_height), die Bildrate (frame_rate) und die berechnete Laufzeit (duration_hh_mm_ss),das verwendete InsightFace-Modellpaket (
model) und das Rechengerät (device),der Zeitpunkt des Analysebeginns in UTC (
analysis_timestamp) und die benötigte Rechenzeit (processing_time_hh_mm_ss),die Anzahl der zur Analyse ausgewählten Frames (
selected_frames), die verwendeten SchwellenwerteFACE_DETECTION_THRESHOLDundCHARACTER_RECOGNITION_THRESHOLD, die Anzahl der übersprungenen Frames (SKIP_FRAMES) und die Toleranz beim Zusammenfügen der Annotationen (TOLERANCE_FRAMES).
Da nicht jeder Frame analysiert wird, kann die Auftrittsdauer einer Figur nur näherungsweise bestimmt werden. Hierfür wird die Anzahl der Frames, in denen die Figur erkannt wurde, mit dem Abstand zwischen den analysierten Frames multipliziert und anschließend durch die Bildrate geteilt. Bei SKIP_FRAMES = 4 entspricht ein erkannter Frame somit einem Zeitraum von ungefähr fünf Frames. Die berechnete Auftrittsdauer ist daher eine Schätzung und keine exakte Messung der tatsächlichen Bildschirmzeit.
# Convert individual character detections into tables and summary statistics.
for video_name, video in videos.items():
    print(f"Opening folder {video_name}.")
    print(DIVIDER)

    video["df_detections"] = []

    for char_name, char in video["char_frames"].items():
        # Create one table per character; its index stores the original frame number.
        df = pd.DataFrame.from_dict(char, orient='index')
        df["char_name"] = char_name
        df.index.name = "framecount"
        video["df_detections"].append(df)

        # Calculate detection counts and mean similarity/confidence values.
        total_char = len(df)
        dot_mean = str(round(df["dot"].mean(), 2))
        score_mean = str(round(df["score"].mean(), 2))
        print(video["metadata"])
        # Estimate screen time from sampled frames and the original frame rate.
        time_sum_s = total_char  * (SKIP_FRAMES + 1)  * (1 / video["metadata"]["frame_rate"])
        time_sum_hh_mm_ss = str(datetime.timedelta(seconds=round(time_sum_s)))

        # Store the calculated character statistics alongside the video metadata.
        video["metadata"].update({
            f"{char_name}_detected_frames"      : total_char,
            f"{char_name}_dot_mean"             : dot_mean,
            f"{char_name}_score_mean"           : score_mean,
            f"{char_name}_time_sum_s"           : time_sum_s,
            f"{char_name}_time_sum_hh_mm_ss"    : time_sum_hh_mm_ss
        })
        print(f"Saved results for {char_name}.")

        print(f"Found {char_name} in {total_char} frames,")
        print(f"with an average face detection score of {score_mean} while using a threshold of {FACE_DETECTION_THRESHOLD},")
        print(f"and an average dot-product of {dot_mean} while using a threshold of {CHARACTER_RECOGNITION_THRESHOLD}.")
        print(f"{char_name} appeared approximately for {time_sum_hh_mm_ss}.")
        print(DIVIDER)
    print(DIVIDER)
Opening folder Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
{'video_name': 'Der geteilte Himmel_Trailer_1964.mp4', 'title': 'Der geteilte Himmel_Trailer', 'release_year': 1964, 'frame_count': 5225, 'frame_height': 1080, 'frame_width': 1920, 'frame_rate': 25.0, 'duration_hh_mm_ss': '0:03:29', 'model': 'buffalo_m', 'device': 'cpu', 'analysis_timestamp': '2026-10-29T15:23:06+00:00', 'processing_time_hh_mm_ss': '0:08:28', 'face_detection_threshold': 0.3, 'character_recognition_threshold': 0.3, 'skip_frames': 4, 'selected_frames': 1045, 'tolerance_frames': 25}
Saved results for Rita.
Found Rita in 390 frames,
with an average face detection score of 0.75 while using a threshold of 0.3,
and an average dot-product of 0.62 while using a threshold of 0.3.
Rita appeared approximately for 0:01:18.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
{'video_name': 'Der geteilte Himmel_Trailer_1964.mp4', 'title': 'Der geteilte Himmel_Trailer', 'release_year': 1964, 'frame_count': 5225, 'frame_height': 1080, 'frame_width': 1920, 'frame_rate': 25.0, 'duration_hh_mm_ss': '0:03:29', 'model': 'buffalo_m', 'device': 'cpu', 'analysis_timestamp': '2026-10-29T15:23:06+00:00', 'processing_time_hh_mm_ss': '0:08:28', 'face_detection_threshold': 0.3, 'character_recognition_threshold': 0.3, 'skip_frames': 4, 'selected_frames': 1045, 'tolerance_frames': 25, 'Rita_detected_frames': 390, 'Rita_dot_mean': '0.62', 'Rita_score_mean': '0.75', 'Rita_time_sum_s': 78.0, 'Rita_time_sum_hh_mm_ss': '0:01:18'}
Saved results for Manfred.
Found Manfred in 276 frames,
with an average face detection score of 0.8 while using a threshold of 0.3,
and an average dot-product of 0.68 while using a threshold of 0.3.
Manfred appeared approximately for 0:00:55.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Zusammenfügen der Frames zu Annotationen#
Die bisher erstellten Tabellen enthalten einzelne Frames, in denen eine Figur erkannt wurde. Um daraus längere, zusammenhängende Zeitintervalle zu erstellen, werden die erkannten Frames jeder Figur zunächst nach ihrer zeitlichen Position sortiert und anschließend zu Annotationen zusammengefügt.
Dabei wird der zuvor festgelegte Parameter TOLERANCE_FRAMES angewendet. Bei der Analyse kann es vorkommen, dass eine Figur in einzelnen Frames nicht erkannt wird, obwohl sie weiterhin im Bild zu sehen ist, beispielsweise aufgrund ungünstiger Kamerawinkel, verdeckter Gesichter oder schlechter Bildqualität. Zudem werden durch SKIP_FRAMES nicht alle Frames einer Videodatei untersucht.
Das Notebook berücksichtigt deshalb sowohl den regulären Abstand zwischen den analysierten Frames (SKIP_FRAMES + 1) als auch die zusätzlich festgelegte Toleranz (TOLERANCE_FRAMES). Liegen zwei aufeinanderfolgende Erkennungstreffer derselben Figur innerhalb dieses Abstands, werden sie zu einer gemeinsamen Annotation zusammengefasst. Andernfalls beginnt eine neue Annotation.
Bei den voreingestellten Werten SKIP_FRAMES = 4 und TOLERANCE_FRAMES = 25 dürfen die Positionen zweier aufeinanderfolgender Erkennungstreffer höchstens 30 Frames auseinanderliegen, damit sie zu einer gemeinsamen Annotation zusammengefügt werden.
Diese Zusammenfassung ermöglicht längere, zusammenhängende Annotationen, bedeutet allerdings nicht, dass die Figur nachweislich in sämtlichen dazwischenliegenden Frames zu sehen ist. Die erzeugten Intervalle stellen daher lediglich eine Annäherung an die tatsächlichen Figurenauftritte dar.
Für jede Annotation werden der Figurenname, die Videodatei sowie Start- und Endpositionen in Frames, Sekunden und Stunden:Minuten:Sekunden gespeichert. Abschließend werden die Annotationen aller erkannten Figuren eines Videos in einem gemeinsamen DataFrame zusammengeführt.
# Merge nearby detections of the same character into time intervals.
for video_name, video in videos.items():
    print(f"Opening folder {video_name}.")
    print(DIVIDER)
    video_name = video["video_path"].name
    all_dfs = []

    # Process the detections of each character separately.
    for df in video["df_detections"]:

        if df.empty:
            continue

        # Sort detections by their original frame positions.
        df = df.sort_index()
        char_name = df["char_name"].iloc[0]

        annotations = []
        # Use original frame positions to determine interval boundaries.
        frames = df.index.tolist()

        # Begin the first interval at the first detected frame.
        start = frames[0]
        prev = frames[0]

        # Allow the usual sampling gap plus TOLERANCE_FRAMES extra frames.
        for frame in frames[1:]:
            if frame - prev <= int(SKIP_FRAMES) + int(TOLERANCE_FRAMES) + 1:
                prev = frame
            else:
                # Close the previous interval when the gap is too large.
                annotations.append({
                    "video"             : video_name,
                    "character"         : char_name,
                    "start"             : start,
                    "end"               : prev,
                    "start_s"           : df.loc[start, "time_s"],
                    "end_s"             : df.loc[prev, "time_s"],
                    "start_hh_mm_ss"    : df.loc[start, "time_hh_mm_ss"],
                    "end_hh_mm_ss"      : df.loc[prev, "time_hh_mm_ss"],
                })

                start = frame
                prev = frame

        # Add the final interval for this character.
        annotations.append({
            "video"             : video_name,
            "character"         : char_name,
            "start"             : start,
            "end"               : prev,
            "start_s"           : df.loc[start, "time_s"],
            "end_s"             : df.loc[prev, "time_s"],
            "start_hh_mm_ss"    : df.loc[start, "time_hh_mm_ss"],
            "end_hh_mm_ss"      : df.loc[prev, "time_hh_mm_ss"],
        })

        # Turn the intervals into a table.
        df_annotations = pd.DataFrame(annotations)

        if df_annotations is not None and not df.empty:
            all_dfs.append(df_annotations)

        print(f"Created {len(df_annotations)} annotations with a tolerance of {TOLERANCE_FRAMES} frames.")
        print(df_annotations[["start_hh_mm_ss", "end_hh_mm_ss"]].head(10))
        print(DIVIDER)
        print(DIVIDER)

    # Combine the annotation tables for all detected characters in this video.
    combined_df = pd.concat(
        all_dfs,
        ignore_index=True
    )

    print(combined_df)
    video["df_annotations"] = combined_df
    print(f"Combined all annotation dfs for folder {video_name}.")
    print(DIVIDER)
Opening folder Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Created 11 annotations with a tolerance of 25 frames.
  start_hh_mm_ss end_hh_mm_ss
0        0:00:07      0:00:18
1        0:00:21      0:00:22
2        0:00:40      0:00:49
3        0:00:51      0:00:51
4        0:00:58      0:01:02
5        0:01:03      0:01:12
6        0:01:28      0:01:44
7        0:02:01      0:02:12
8        0:02:17      0:02:25
9        0:02:50      0:02:50
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Created 6 annotations with a tolerance of 25 frames.
  start_hh_mm_ss end_hh_mm_ss
0        0:00:43      0:00:43
1        0:01:00      0:01:12
2        0:01:28      0:01:44
3        0:02:01      0:02:12
4        0:02:26      0:02:32
5        0:02:56      0:03:06
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
                                   video character  start   end  start_s  \
0   Der geteilte Himmel_Trailer_1964.mp4      Rita    180   445      7.2
1   Der geteilte Himmel_Trailer_1964.mp4      Rita    520   540     20.8
2   Der geteilte Himmel_Trailer_1964.mp4      Rita   1000  1215     40.0
3   Der geteilte Himmel_Trailer_1964.mp4      Rita   1275  1275     51.0
4   Der geteilte Himmel_Trailer_1964.mp4      Rita   1445  1540     57.8
5   Der geteilte Himmel_Trailer_1964.mp4      Rita   1580  1795     63.2
6   Der geteilte Himmel_Trailer_1964.mp4      Rita   2205  2595     88.2
7   Der geteilte Himmel_Trailer_1964.mp4      Rita   3035  3305    121.4
8   Der geteilte Himmel_Trailer_1964.mp4      Rita   3425  3615    137.0
9   Der geteilte Himmel_Trailer_1964.mp4      Rita   4250  4255    170.0
10  Der geteilte Himmel_Trailer_1964.mp4      Rita   4665  4935    186.6
11  Der geteilte Himmel_Trailer_1964.mp4   Manfred   1080  1085     43.2
12  Der geteilte Himmel_Trailer_1964.mp4   Manfred   1490  1795     59.6
13  Der geteilte Himmel_Trailer_1964.mp4   Manfred   2195  2595     87.8
14  Der geteilte Himmel_Trailer_1964.mp4   Manfred   3035  3305    121.4
15  Der geteilte Himmel_Trailer_1964.mp4   Manfred   3645  3790    145.8
16  Der geteilte Himmel_Trailer_1964.mp4   Manfred   4410  4660    176.4

    end_s start_hh_mm_ss end_hh_mm_ss
0    17.8        0:00:07      0:00:18
1    21.6        0:00:21      0:00:22
2    48.6        0:00:40      0:00:49
3    51.0        0:00:51      0:00:51
4    61.6        0:00:58      0:01:02
5    71.8        0:01:03      0:01:12
6   103.8        0:01:28      0:01:44
7   132.2        0:02:01      0:02:12
8   144.6        0:02:17      0:02:25
9   170.2        0:02:50      0:02:50
10  197.4        0:03:07      0:03:17
11   43.4        0:00:43      0:00:43
12   71.8        0:01:00      0:01:12
13  103.8        0:01:28      0:01:44
14  132.2        0:02:01      0:02:12
15  151.6        0:02:26      0:02:32
16  186.4        0:02:56      0:03:06
Combined all annotation dfs for folder Der geteilte Himmel_Trailer_1964.mp4.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
4.9.6. Export der Ergebnisse#
Die Analyseergebnisse werden als nächstes in mehreren Formaten gespeichert. .csv-Dateien eignen sich für Tabellenkalkulation, Statistikprogramme und weitere Python-Auswertungen, etwa zur Visualisierung. Zudem können sie auch in OpenRefine eingelesen werden. Die Verwendung von OpenRefine wird in der OER zu OER zu Studentischen Filmen an der Filmuniversität genauer erklärt, ebenso das csv-Dateiformat.
Das .eaf-Format kann direkt in VIAN oder anderen Programmen zur Videoannotation geöffnet oder importiert werden, die Daten können dann dort manuell überprüft, bearbeitet und ergänzt werden.
Beim erneuten Export werden zusätzliche Versionen der Ergebnisdateien erstellt. Vorhandene Dateien bleiben erhalten.
Export der Tabellen als .csv-Dateien#
Die Ergebnisse der Figurenerkennung werden für jedes Video in drei .csv-Dateien exportiert:
Die Datei
…_characters_frames.csventhält die einzelnen Erkennungstreffer. Für jeden Treffer werden die Position des Frames, der Zeitpunkt in Sekunden und Stunden:Minuten, der Figurenname sowie der Ähnlichkeitswert und der Konfidenzwert der Gesichtsdetektion gespeichert.Die Datei
…_characters_annotations.csventhält die zusammengefügten Annotationen der Figurenauftritte. Jede Zeile entspricht einem Zeitintervall und enthält die Videodatei, den Figurennamen sowie Start- und Endpositionen in Frames, Sekunden und Stunden:Minuten.Die Datei
…_characters_metadata.csventhält die allgemeinen Metadaten des Videos, die verwendeten Analyseparameter und die berechneten statistischen Metadaten der einzelnen Figuren.
Weitere Informationen finden Sie im OER-Abschnitt zur Ausgabe des Notebooks
Für jedes Video wird im zuvor festgelegten Exportordner (EXPORT_PATH) ein eigener Unterordner angelegt. Dieser übernimmt den Namen des entsprechenden Eingabe-Unterordners, unabhängig vom tatsächlichen Dateinamen des Videos. Auch die Namen der exportierten Dateien werden aus diesem Ordnernamen gebildet. Alle drei Dateien werden im jeweiligen Unterordner gespeichert.
Die folgende Hilfsfunktion next_export_paths() prüft für jedes Video die drei vorgesehenen CSV-Dateien und die zugehörige EAF-Datei gemeinsam. Beim ersten Export bleiben die ursprünglichen Dateinamen erhalten. Ist mindestens eine dieser Dateien bereits vorhanden, wird für alle Dateien des nächsten Exports derselbe freie Versionszusatz vergeben (_v2, _v3 usw.). Ein zweiter Export kann beispielsweise Filmname_characters_frames_v2.csv, Filmname_characters_annotations_v2.csv, Filmname_characters_metadata_v2.csv und Filmname_characters_annotations_v2.eaf erzeugen. Auch eine unvollständige frühere Ausgabe reserviert ihre Versionsnummer.
Die gewählten Dateipfade werden unter video["export_paths"] gespeichert und anschließend beim EAF-Export wiederverwendet. Für eine neue vollständige Version werden zuerst die CSV-Exportzelle und danach die EAF-Exportzelle ausgeführt. Wird nur die EAF-Exportzelle erneut ausgeführt, bleibt eine bereits vorhandene EAF-Datei erhalten.
# Select one version for all export files belonging to the same video.
# Find a free version for the complete group of CSV and EAF files.
def next_export_paths(paths):
    version = 1
    while True:
        # The first export has no suffix; later versions use _v2, _v3, etc.
        suffix = "" if version == 1 else f"_v{version}"
        candidates = {
            kind: path.with_name(f"{path.stem}{suffix}{path.suffix}")
            for kind, path in paths.items()
        }
        # Even one existing file reserves this version for the whole group.
        if not any(path.exists() for path in candidates.values()):
            return candidates
        version += 1

# Export one set of three CSV tables for each video folder.
export_directory = Path(EXPORT_PATH)

for video_name, video in videos.items():

    # Combine frame detections and retrieve the interval and metadata tables.
    df_detections = pd.concat(video["df_detections"], ignore_index=False)
    df_annotations = video["df_annotations"].copy()
    df_metadata = pd.DataFrame.from_dict(
        video["metadata"], orient="index", columns=["Value"]
    )

    # Create an output folder named after the input subdirectory.
    video_path = export_directory / video_name
    video_path.mkdir(parents=True, exist_ok=True)

    # Choose a shared version for all three CSV files and the later EAF file.
    video["export_paths"] = next_export_paths({
        "frames": video_path / f"{video_name}_characters_frames.csv",
        "annotations": video_path / f"{video_name}_characters_annotations.csv",
        "metadata": video_path / f"{video_name}_characters_metadata.csv",
        "eaf": video_path / f"{video_name}_characters_annotations.eaf",
    })
    paths = video["export_paths"]

    # Preserve the original frame numbers stored in the DataFrame index.
    # mode="x" prevents an existing CSV file from being overwritten.
    df_detections.to_csv(paths["frames"], index=True, index_label="framecount", mode="x")
    print(f"Exported {paths['frames'].name} to {video_path}.")
    print(DIVIDER)

    # Annotation and metadata tables do not need an extra index column.
    df_annotations.to_csv(paths["annotations"], index=False, mode="x")
    print(f"Exported {paths['annotations'].name} to {video_path}.")
    print(DIVIDER)

    # Store metadata as key-value pairs, one metadata entry per row.
    df_metadata.to_csv(paths["metadata"], index=True, header=False, mode="x")
    print(f"Exported {paths['metadata'].name} to {video_path}.")
    print(DIVIDER)
Exported Der geteilte Himmel_Trailer_1964_characters_frames.csv to export_characters/Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Exported Der geteilte Himmel_Trailer_1964_characters_annotations.csv to export_characters/Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Exported Der geteilte Himmel_Trailer_1964_characters_metadata.csv to export_characters/Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Export der Figuren-Annotationen als .eaf-Datei#
Zusätzlich zu den Tabellen werden die erkannten Figurenauftritte als Annotationsdatei im .eaf-Format unter dem Namen …_characters_annotations.eaf exportiert.
Für jede erkannte Figur wird eine eigene Annotationsebene angelegt, deren Name dem aus den Referenzabbildungen ermittelten Figurennamen entspricht. Die Annotationen beschreiben die Zeitintervalle, in denen die jeweilige Figur erkannt wurde. Die Annotationsebenen werden absteigend anhand der aufsummierten Dauer dieser Intervalle sortiert.
Falls für das jeweilige Video zusätzlich eine .csv-Datei mit zuvor erkannten Einstellungen vorhanden ist, werden weitere Annotationsebenen erstellt:
Die Ebene
shotsenthält die vollständigen erkannten Einstellungen des Videos.Für jede erkannte Figur wird außerdem eine Ebene mit der Endung
_matchedangelegt. Diese enthält alle vollständigen Einstellungen, die sich zeitlich mit mindestens einem erkannten Auftritt der jeweiligen Figur überschneiden. Dadurch lässt sich nachvollziehen, in welchen Einstellungen eine Figur erkannt wurde, auch wenn ihr Auftritt nur einen Teil der Einstellung umfasst.
Ist keine Einstellungs-CSV vorhanden, werden diese zusätzlichen Ebenen nicht angelegt. Die Figurenannotation kann dennoch exportiert werden.
Die einzelnen Annotationen enthalten keinen zusätzlichen Text, sondern dienen der zeitlichen Segmentierung des Videos. Nach dem Import in VIAN oder ein anderes geeignetes Annotationsprogramm können sie manuell überprüft, korrigiert und inhaltlich ergänzt werden.
Bei wiederholtem Export bleiben frühere Versionen der .eaf-Datei erhalten.
# Export detected character intervals and optional shot annotations as EAF tiers.
export_directory = Path(EXPORT_PATH)

for video_name, video in videos.items():
    print(f"Opening folder {video_name}.")
    print(DIVIDER)

    # Reuse the version selected when the CSV files were exported.
    if "export_paths" not in video:
        raise RuntimeError("Run the CSV export cell before exporting EAF files.")
    eaf_path = video["export_paths"]["eaf"]

    # Do not overwrite the EAF if only this cell is executed again.
    if eaf_path.exists():
        print(f"Skipping {eaf_path.name}: file already exists. Re-run the CSV export cell for a new version.")
        print(DIVIDER)
        continue

    df_annotations = video.get("df_annotations", pd.DataFrame()).copy()
    shots_csv = video.get("shots_csv")

    if df_annotations.empty:
        print(
            f"No annotations found for folder {video_name}. "
            "No .eaf file will be exported."
        )
        print(DIVIDER)
        continue

    # Add one video frame to include the final detected frame in each interval.
    frame_duration_s = 1 / video["metadata"]["frame_rate"]

    # Create an empty EAF document for this video.
    eaf = pympi.Eaf()

    # Sort character tiers by the summed duration of their annotation intervals.
    char_screen_times = (
        df_annotations.assign(
            duration=lambda df: (
                df["end_s"] - df["start_s"] + frame_duration_s
            ).clip(lower=0)
        )
        .dropna(subset=["character"])
        .groupby("character")["duration"]
        .sum()
        .sort_values(ascending=False)
    )

    char_names = char_screen_times.index.tolist()

    for char_name, screen_time in char_screen_times.items():
        print(f"{char_name}: {screen_time:.2f} seconds")

    shots = []

    # Include the original shot boundaries if a shot-detection CSV is available.
    if shots_csv:
        print(f"Including {shots_csv.name}.")
        shots_df = pd.read_csv(shots_csv)

        eaf.add_tier("shots")

        shots = [
            (
                float(row["start_s"]),
                float(row["end_s"]) + frame_duration_s
            )
            for _, row in shots_df.iterrows()
        ]

        for char_name in char_names:
            eaf.add_tier(f"{char_name}_matched")

    for char_name in char_names:
        eaf.add_tier(str(char_name))

    # Copy unique shot intervals into the dedicated shots tier.
    if shots_csv:
        added_shots = set()

        for shot_start, shot_end in shots:
            shot_key = (
                int(round(shot_start * 1000)),
                int(round(shot_end * 1000))
            )

            if shot_key not in added_shots:
                eaf.add_annotation(
                    "shots",
                    shot_key[0],
                    shot_key[1]
                )
                added_shots.add(shot_key)

        # Add complete shots overlapping a character interval to matched tiers.
        added_matches = set()

        for char_name in char_names:
            print(f"Calculating matched shots for {char_name}.")

            char_df = df_annotations[
                df_annotations["character"] == char_name
            ]

            for _, row in char_df.iterrows():
                annotation_start = float(row["start_s"])
                annotation_end = float(row["end_s"]) + frame_duration_s

                for shot_start, shot_end in shots:
                    # Match any shot overlapping the character interval.
                    overlaps = (
                        annotation_start < shot_end
                        and annotation_end > shot_start
                    )

                    if overlaps:
                        match_key = (
                            char_name,
                            int(round(shot_start * 1000)),
                            int(round(shot_end * 1000))
                        )

                        if match_key not in added_matches:
                            eaf.add_annotation(
                                f"{char_name}_matched",
                                match_key[1],
                                match_key[2]
                            )
                            added_matches.add(match_key)

    # Export each character interval, including its final detected frame.
    for char_name in char_names:
        char_df = df_annotations[
            df_annotations["character"] == char_name
        ]

        for _, row in char_df.iterrows():
            start_ms = int(
                round(float(row["start_s"]) * 1000)
            )
            end_ms = int(
                round((float(row["end_s"]) + frame_duration_s) * 1000)
            )

            # Avoid zero-length intervals after rounding to milliseconds.
            if end_ms <= start_ms:
                frame_duration_ms = max(
                    1,
                    int(
                        round(
                            1000 / video["metadata"]["frame_rate"]
                        )
                    )
                )
                end_ms = start_ms + frame_duration_ms

            eaf.add_annotation(
                str(char_name),
                start_ms,
                end_ms
            )

    # Save the EAF using the same version as the previously exported CSVs.
    eaf.to_file(eaf_path)
    video["eaf_path"] = eaf_path

    print(f"Exported {eaf_path.name} to {eaf_path.parent}.")
    print(DIVIDER)
Opening folder Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Rita: 77.84 seconds
Manfred: 55.24 seconds
Including Der geteilte Himmel_Trailer_1964_shots_0.5.csv.
Calculating matched shots for Rita.
Calculating matched shots for Manfred.
Exported Der geteilte Himmel_Trailer_1964_characters_annotations.eaf to export_characters/Der geteilte Himmel_Trailer_1964.
────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────────
Herunterladen des Google Colab Export-Ordners#
Dieser optionale Schritt ist nur für eine Ausführung in Google Colab vorgesehen. Der gesamte Exportordner in Colab wird zu einer .zip-Datei komprimiert und anschließend über die Browseroberfläche heruntergeladen. Der Download ist notwendig, da ansonsten die Erkennungsdaten verloren gehen, da diese nach Beenden der Laufzeit bzw. von Colab immer gelöscht werden, ebenso wie alle in Colab zur Analyse hochgeladenen Videodateien.
In einer lokalen Jupyter Notebook-Umgebung bleiben die Dateien im anfangs im Codeblock zur Festlegung der Parameter definierten Export-Ordner erhalten und können von dort entnommen werden. Es ist daher kein zusätzlicher Download-Schritt erforderlich.
# Download the complete export directory as a ZIP archive in Google Colab.
if colab:

    export_directory = f"/content/{EXPORT_PATH}"
    zip_path = f"{EXPORT_PATH}.zip"

    # Compress the results before triggering the browser download.
    !zip -r "{zip_path}" "{export_directory}"

    files.download(zip_path)

    print(f"Downloaded {EXPORT_PATH}.zip.")

else:
    # Local executions retain the results in the export directory.
    print("Download only works in Google Colab.")
Download only works in Google Colab.