4.3. Auswahl der Modelle#
Die Auswahl eines Machine-Learning-Modells hängt davon ab, welche Aufgabe es erfüllen soll und wie die Ergebnisse weiterverwendet werden. Existierende Literatur wie die im vorherigen Abschnitt erwähnten Fallstudien des Distant Viewing Labs können dabei helfen, sich einen ersten Überblick über die Möglichkeiten der Machine-Learning-gestützten Annotation zu verschaffen. Je nach Fragestellung können auch Modelle genutzt werden, die nicht zur Annotation von Videomaterial vorgesehen sind, sondern z.B. für die Auswertung von Bildern konzipiert wurden. Darüber hinaus können im Fall von Filmen etwa auch Ton und Untertitel mithilfe von Machine-Learning Modellen ausgewertet werden.
4.3.1. Recherche#
Nachdem ein grundlegendes Verfahren wie z.B. die Erkennung von Figuren in Videodateien ausgewählt wurde, kann auf unterschiedlichen Plattformen anhand von englischen Stichworten nach passenden Komponenten für das Verfahren gesucht werden. In der Vorbereitung zu dieser OER haben wir u.a. diese Stichworte für die Recherche verwendet:
Shot detection
Face detection
Object detection
Depth detection
image captioning
Hugging Face bietet vielfältige Möglichkeiten, nach Machine-Learning-Modellen zu suchen und diese zu vergleichen. Zu vielen Modellen gibt es Angaben zu ihrer vorgesehenen Anwendung, den verwendeten Trainingsdaten und deren konkreten Nutzung. Diese Angaben bieten eine erste Orientierung, ihre Qualität und Vollständigkeit kann jedoch unterschiedlich sein. Im Reiter ‘Models’ können außerdem Filter für die Suche nach Modellen angelegt werden, unter anderem auch für ‘Tasks’, also Verfahren:
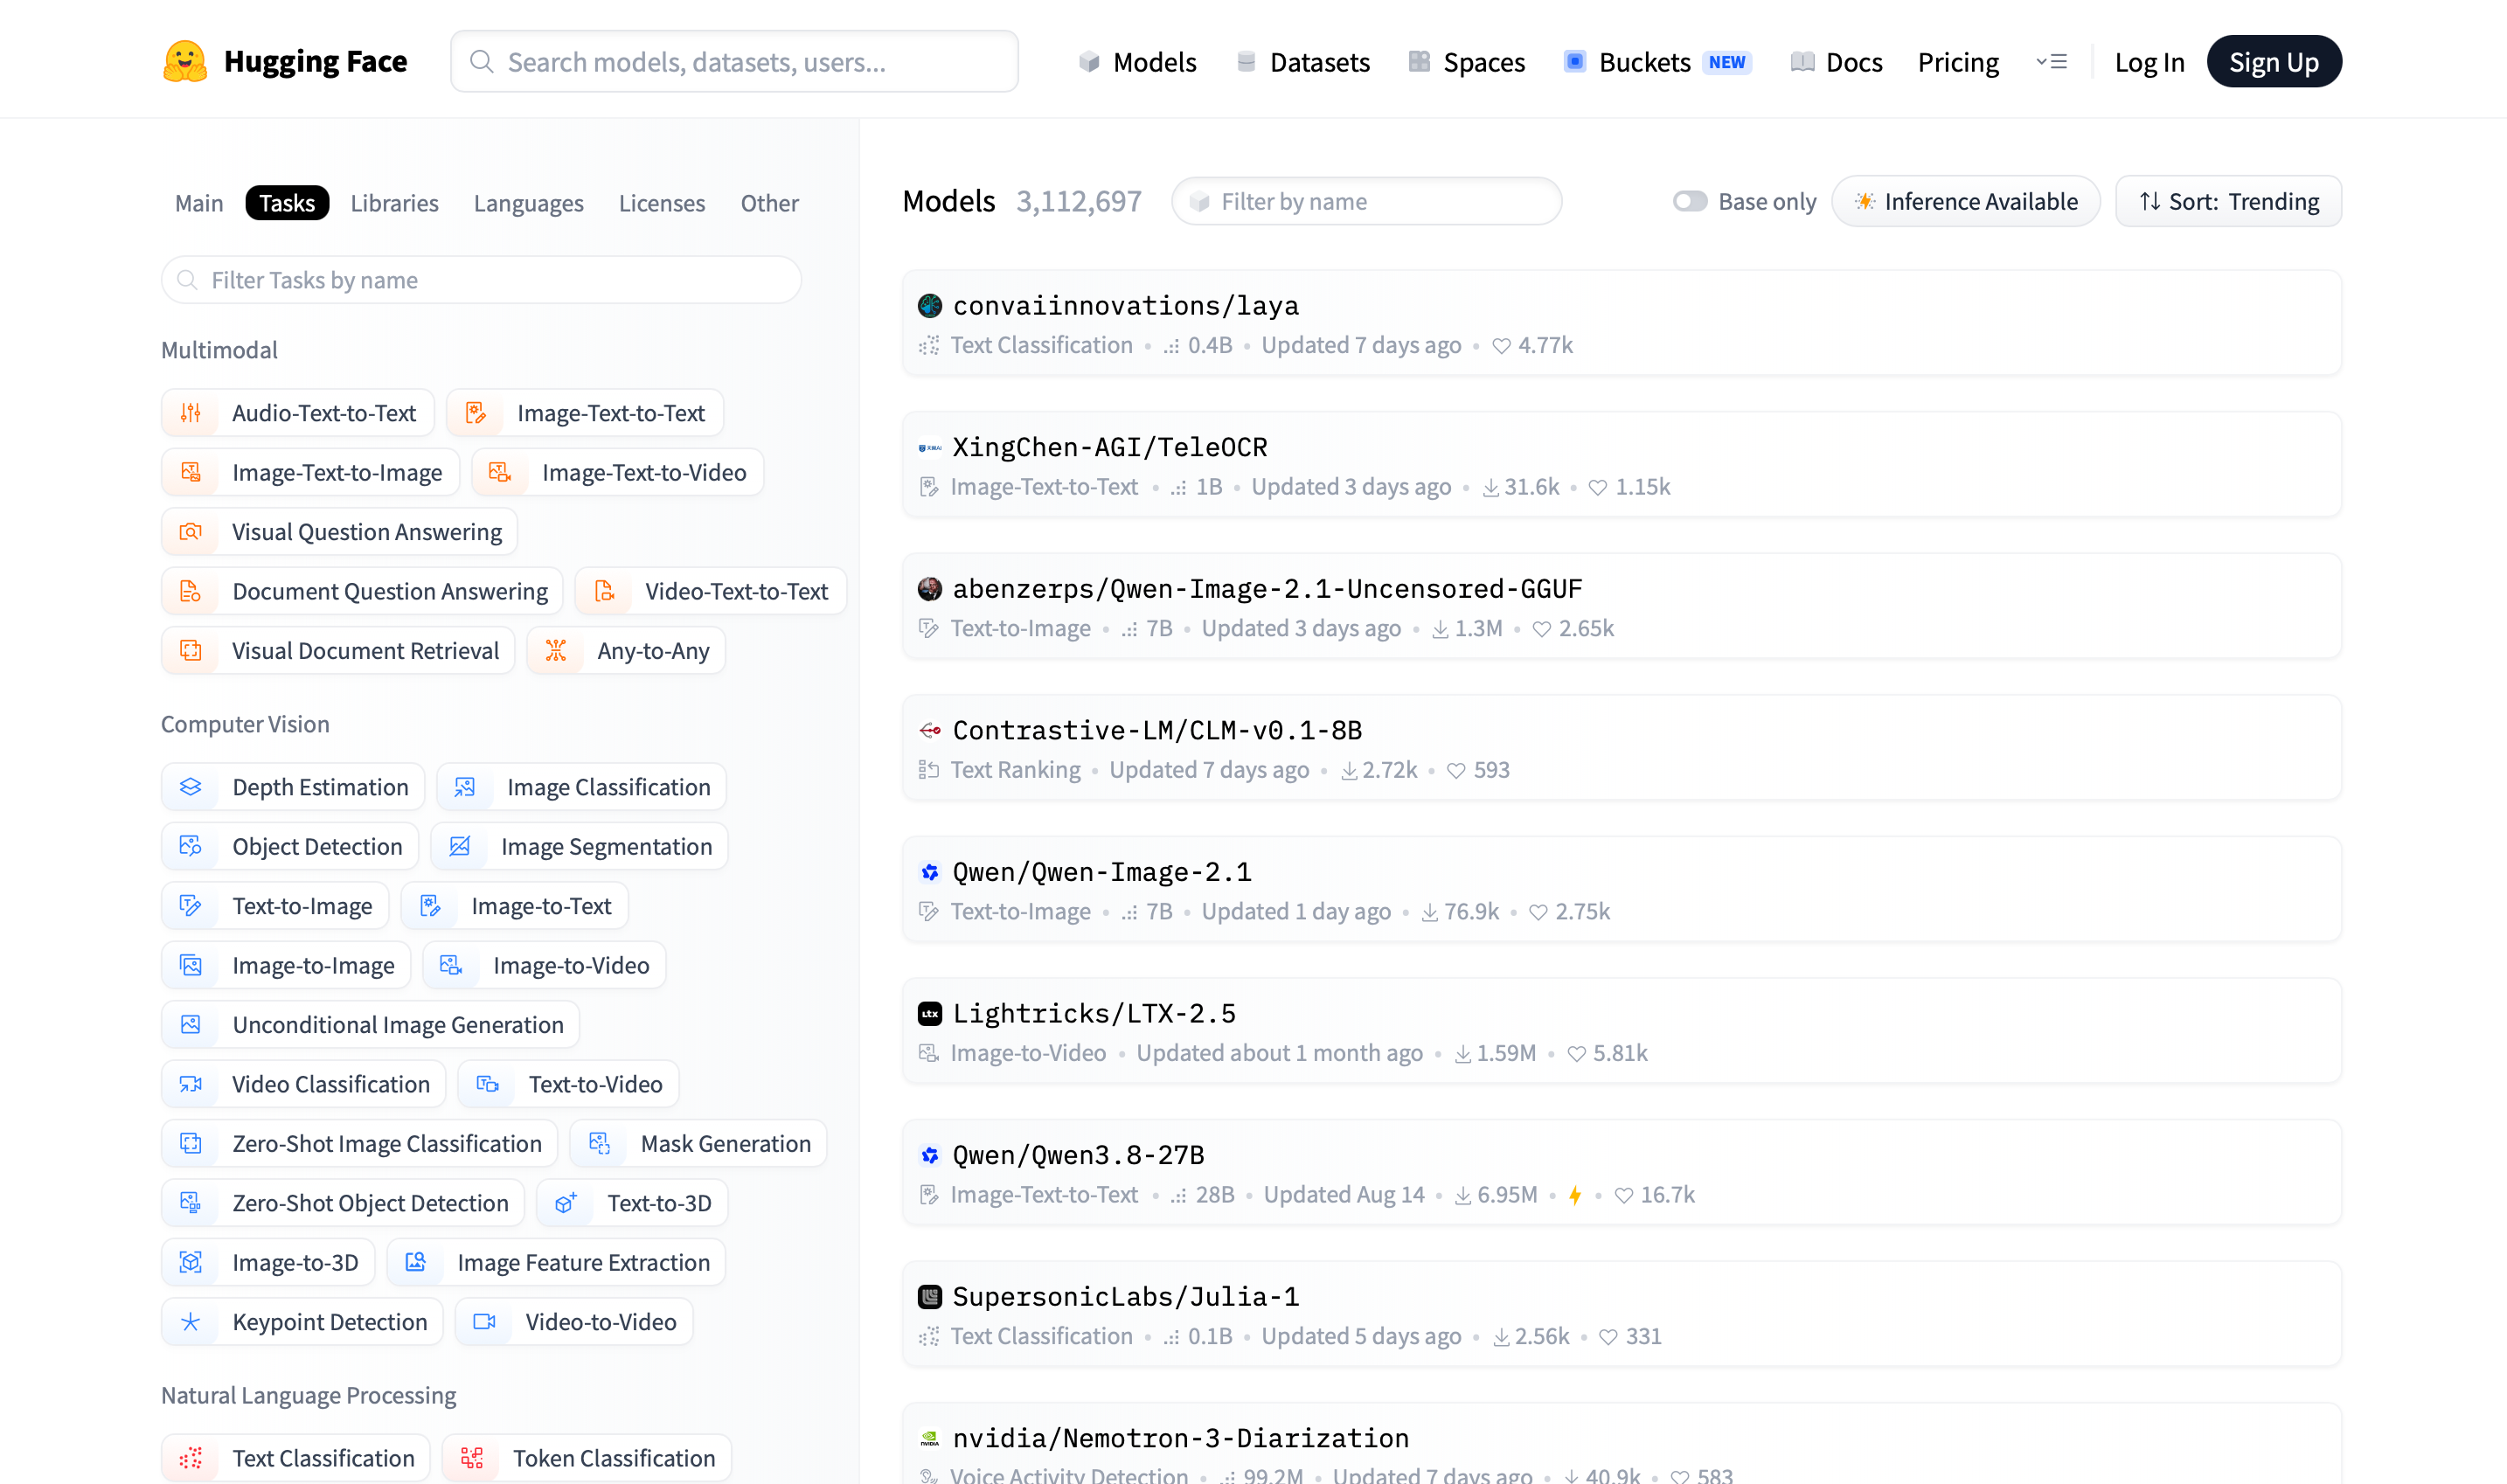
Fig. 4.3 Die Suchmaske von Huggingface mit Filteroptionen.#
Auf arXiv kann hingegen nach wissenschaftlichen Arbeiten aus dem Bereich Machine-Learning gesucht werden. Die Veröffentlichungen erläutern häufig, wie ein Modell entwickelt und getestet wurde. Ein dort verfügbarer Text kann ein Preprint sein und muss nicht bereits ein Peer-Review-Verfahren durchlaufen haben. Deshalb sollte geprüft werden, ob und wo die Arbeit später veröffentlicht wurde. Die Artikel können wertvolle Hinweise auf für das Verfahren passende Modelle liefern.
Auf PyPI sind Python-Bibliotheken auffindbar, die sich installieren und in eigene Arbeitsabläufe einbinden lassen. Die Einträge enthalten unter anderem Angaben zu Versionen und Abhängigkeiten von anderen Bibliotheken. Häufig adaptieren solche Bibliotheken existierende Machine-Learning Modelle für Python und werden von Personen erstellt und gepflegt, die nicht an der Entwicklung des ursprünglichen Modells beteiligt waren. Solche inoffiziellen Bibliotheken können in ihrer Qualität stark variieren und sich in ihrer Anwendungen zu offiziellen Anwendungsbereichen unterscheiden. Auch hier müssen die im eigenen Projekt verwendeten Bibliotheken also sorgfältig geprüft und ausgewählt werden.
Ergänzend bietet sich eine Suche auf GitHub an, einer Plattform zur Erstellung von Software. Dort können Quellcode, Dokumentation und Beispiele von Software-Projekten gefunden werden, unter anderem auch zu Machine-Learning. Hinweise wie aktuelle Änderungen der Software oder offene Fehlerberichte können bei der Einschätzung der technischen Nutzbarkeit helfen. Zudem kann auf Fehler im Code hingewiesen oder es können konkrete Anwendungsfälle diskutiert werden.
4.3.2. Auswahl für die Einstellungsanalyse#
Für die Erkennung von Einstellungsübergängen fiel die Wahl auf das Modell TransNetV2. Das Verfahren wird vom Distant Viewing Lab und bei VIAN eingesetzt und ist in weiteren Projekten sowie wissenschaftlichen Arbeiten aufgegriffen worden. Diese Verbreitung sprach dafür, das Modell ebenfalls zu verwenden, um Vergleiche zu anderen Projekten zu ermöglichen. Bekanntheit und Zitierhäufigkeit allein sind jedoch kein Beleg für die Eignung in jedem Forschungskontext und für jedes Videomaterial. Die mit dem Modell erzielten Ergebnisse müssen weiterhin am Analysematerial gesichtet und geprüft werden.
4.3.3. Auswahl für die Gesichtsanalyse#
Für die Gesichtsanalyse haben wir mehrere verbreitete Modelle beziehungsweise Python-Bibliotheken verglichen. Begonnen haben wir mit Deepface, einer Python-Bibliothek, die mehrere Modelle zur Face Detection, also der Erkennung von Gesichtern in einem Bild, und Face Recognition, der Zuordnung des erkannten Gesichts zu einer konkreten Person, zusammenführt. So konnten wir uns einen Überblick über unterschiedliche Modelle mit unterschiedlicher Präzision und Geschwindigkeit verschaffen. Auf den Unterschied zwischen Face Detection und Face Recognition wird im Kapitel zur Einführung in die Figurenerkennung noch genauer eingegangen.
Schließlich haben wir uns jedoch für die Modell-Pakete von Insightface entschieden, die Modelle zur Face Detection und Face Recognition verbinden und so den Code im Jupyter Notebook vereinfachen. Zudem stellte sich in unseren Tests die Genauigkeit der Erkennung und GPU-Beschleunigung der Modelle als ausgezeichnet heraus. Worum genau es sich bei dieser Beschleunigung handelt erläutert das nächste Kapitel zu den technischen Grundlagen.