
2.2. Qualitätsprüfung#
In einem ersten Schritt müssen die zu publizierenden Daten einer Qualitätsprüfung unterzogen werden: genügen die Daten in der Art und Weise wie sie vorliegen den Ansprüchen? Dies gilt in Bezug auf Vollständigkeit, Plausibilität und die Einhaltung der guten wissenschaftlichen Praxis (GWP) [Link].

Abb. 2.3 Die Kompetenz 1.2 Qualitätssicherung des QUADRIGA Datenkompetenzframeworks.#
Quellenangabe: Ausschnitt aus dem Modell „QUADRIGA Datenkompetenzframework“ von Petras et al. unter der Lizenz CC BY 4.0 via Zenodo.
2.2.1. Was ist mit „Qualität“ gemeint?#
Die Qualität der Daten lässt sich in zwei verschiedene Unterkategorien aufteilen: Syntax und Semantik.
Mit Syntax ist gemeint, dass die Datensätze korrekt und richtig formatiert sind, sodass die FAIR-Prinzipien eingehalten werden. In einer vergangenen Fallstudie wurde dies bereits behandelt. Um die Einhaltung der FAIR-Prinzipien sicherzustellen ist demnach besonders wichtig, dass die Datensätze maschinenlesbar sind und relevante Informationen zur Auffindbarkeit nicht im Datensatz selbst, sondern in den Metadaten hinterlegt sind. Doch was wenn die Daten, welche sich im Datensatz befinden zwar korrekt formatiert sind, allerdings einen Wert angenommen haben, welchen sie eigentlich gar nicht haben dürften.
Eine detallierte Übersicht von Qualitätsmerkmalen von Daten und Metadaten finden Sie hier.
Fünf besonders wichtige Kriterien für die Gewährleistung der Datenintegrität sind:
Genauigkeit: Abgleich der Daten mit der tatsächlichen Realität. Wenn beispielsweise ein plötzlicher Anstieg der Klickzahlen durch automatisierte Bots auf einer Website nicht herausgefiltert wird, spiegeln die Daten am Ende des Tages nicht die Realität wieder und sind ungenau.
Vollständigkeit: Bezieht sich auf die Frage, ob alle erforderlichen Felder in einem Datensatz ausgefüllt sind. Wenn bei einer Umfrage Name und E-Mail-Adresse keine Pflichtfelder sind, füllen manche Teilnehmer diese nicht aus, was zu einem unvollständigen Gesamtbild des Kunden führt.
Konsistenz: Bezeichnet die Einheitlichkeit von Daten über verschiedene Systeme hinweg. Wenn das Einkaufsteam Postleitzahlen 5-stellig erfasst, das Marketingteam dieselben Postleitzahlen aber 9-stellig sammelt, passen die Kundeprofile beim Zusammenführen der Datenbanken nicht zusammen.
Eindeutigkeit: Vermeidung von Duplikaten. Hat ein Unternehmen beispielsweise 50.000 Datensätze, von denen aber 20 % Duplikate sind (weil Kunden das Formular mehrfach ausgefüllt haben), besitzt das Unternehmen in Wahrheit 20 % weniger eindeutige Datensätze.
Gültigkeit: Die Konformität der Daten mit vordefinierten syntaktischen Vorgaben, Formatdefinitionen und zulässigen Wertebereichen. Ein ungültiger Wer für ein Datim wäre zum Beispiel „32.13.2025“ [Ramasamy and Chowdhury, 2020].
Um diese zu erfüllen, lohnt es sich anzuschauen, welche Methoden für die Datenbereinigung im Data Engineering üblich sind und auch für Forschende von Bedeutung sein könnten. Hierfür gibt es einige typische Tests, die Sie, angepasst an die von Ihnen erwarteten Ergebnisse, implementieren können.
Bereichsprüfung: Diese Prüfung konzentriert sich primär auf numerische Datensätze, bei denen ein bestimmter Wertebereich (von X bis Y) erwartet wird. Sie kann über Anomalie-Erkennungsmodelle implementiert werden. Wenn ein Wert den typischen Rahmen sprengt (z.B. wenn plötzlich eine Transaktion über eine Million Euro statt der üblichen 1.000 Euro aufläuft), schlägt das System an. Solche Abweichungen müssen nicht zwingend „kaputte“ Daten sein; sie können auch auf fehlerhafte Prozesse hinweisen
Kategorieprüfungen: Hierbei wird geprüft, ob Werte zu einer vordefinierten, sich selten ändernden Gruppe von Einträgen gehören. Ein klassisches Beispiel sind Unterscheidungszeichen bei deutschen KfZ-Kennzeichen (z.B. „B“ für Berlin oder „HH“ für Hamburg) . Wenn ein Prozess ohne Absprache eine neue Kategorie einführt, die dem Datensystem unbekannt ist (in diesem Fall ein Zeichen, welches es in Deutschland nicht gibt), meldet die Kategorieprüfung diesen Fehler.
Aktualitätsprüfung: Diese Prüfung betrifft den Aspekt der Pünktlichkeit und Aktualität (Timelines) von Daten. Es wird gemessen, wie viel Zeit seit dem letzten erfolgreichen Laden der Daten vergangen ist. Wenn ein Bericht beispielsweise zwei Tage lang nicht aktualisiert wurde, führt dies oft zu Frustration bei den Endnutzern, die mit aktuellen Daten arbeiten wollen. Meist wird hierbei eine automatische Warnung ausgelöst, sobald die Verzögerung einen bestimmten Grenzwert überschreitet. Da Sie allerdings mit hoher Wahrscheinlichkeit keine Echtzeitdaten publizieren, spielt dieser Test für Sie keine wirkliche Rolle. Ähnliches gilt für die Volumenprüfung, bei der die Anzahl der täglich geladenen Zeilen (Row Count) überwacht wird. Da die Datenmenge an normalen Tagen meist relativ stabil ist (oft mit Ausnahme des Wochenendes), deutet ein plötzlicher, drastischer Anstieg (z. B. das 3- bis 10-fache Volumen) auf ein Problem hin.
Nullwertprüfung: Da sich Nullwerte in Datenbanken oft unvorhersehbar verhalten, ist dieser Test essenziell. Er stellt entweder sicher, dass überhaupt keine Nullwerte in einer Spalte existieren dürfen, oder er definiert einen maximal zulässigen prozentualen Anteil an leeren Feldern. Bei Bedarf können fehlende Werte auch automatisch mit Standard-Platzhaltern gefüllt werden.
Datentypprüfung: Es wird überprüft, ob die Daten den erwarteten Typ aufweisen (z. B. ob ein Feld ein Datum oder eine Ganzzahl ist). Dies ist besonders kritisch, wenn Daten aus Dateien ohne Spaltenüberschriften (Header) importiert werden, da sich dort die Spaltenreihenfolge unbemerkt verschieben kann. Durch den Test wird verhindert, dass Daten mit ungültigen Formaten im weiteren Datenverarbeitungsprozess verarbeitet werden.
Eindeutigkeitsprüfung: Diese Prüfung stellt sicher, dass Werte in einer Spalte (wie ID-Felder) absolut eindeutig sind und keine Duplikate enthalten [Cai and Zhu, 2015, Ramasamy and Chowdhury, 2020].
2.2.2. Medaillon-Schema#
Im Data Engineering können diese Tests verwendet werden, um die Datenqualität innerhalb des sogenannten Medaillon-Schemas aufzuwerten.
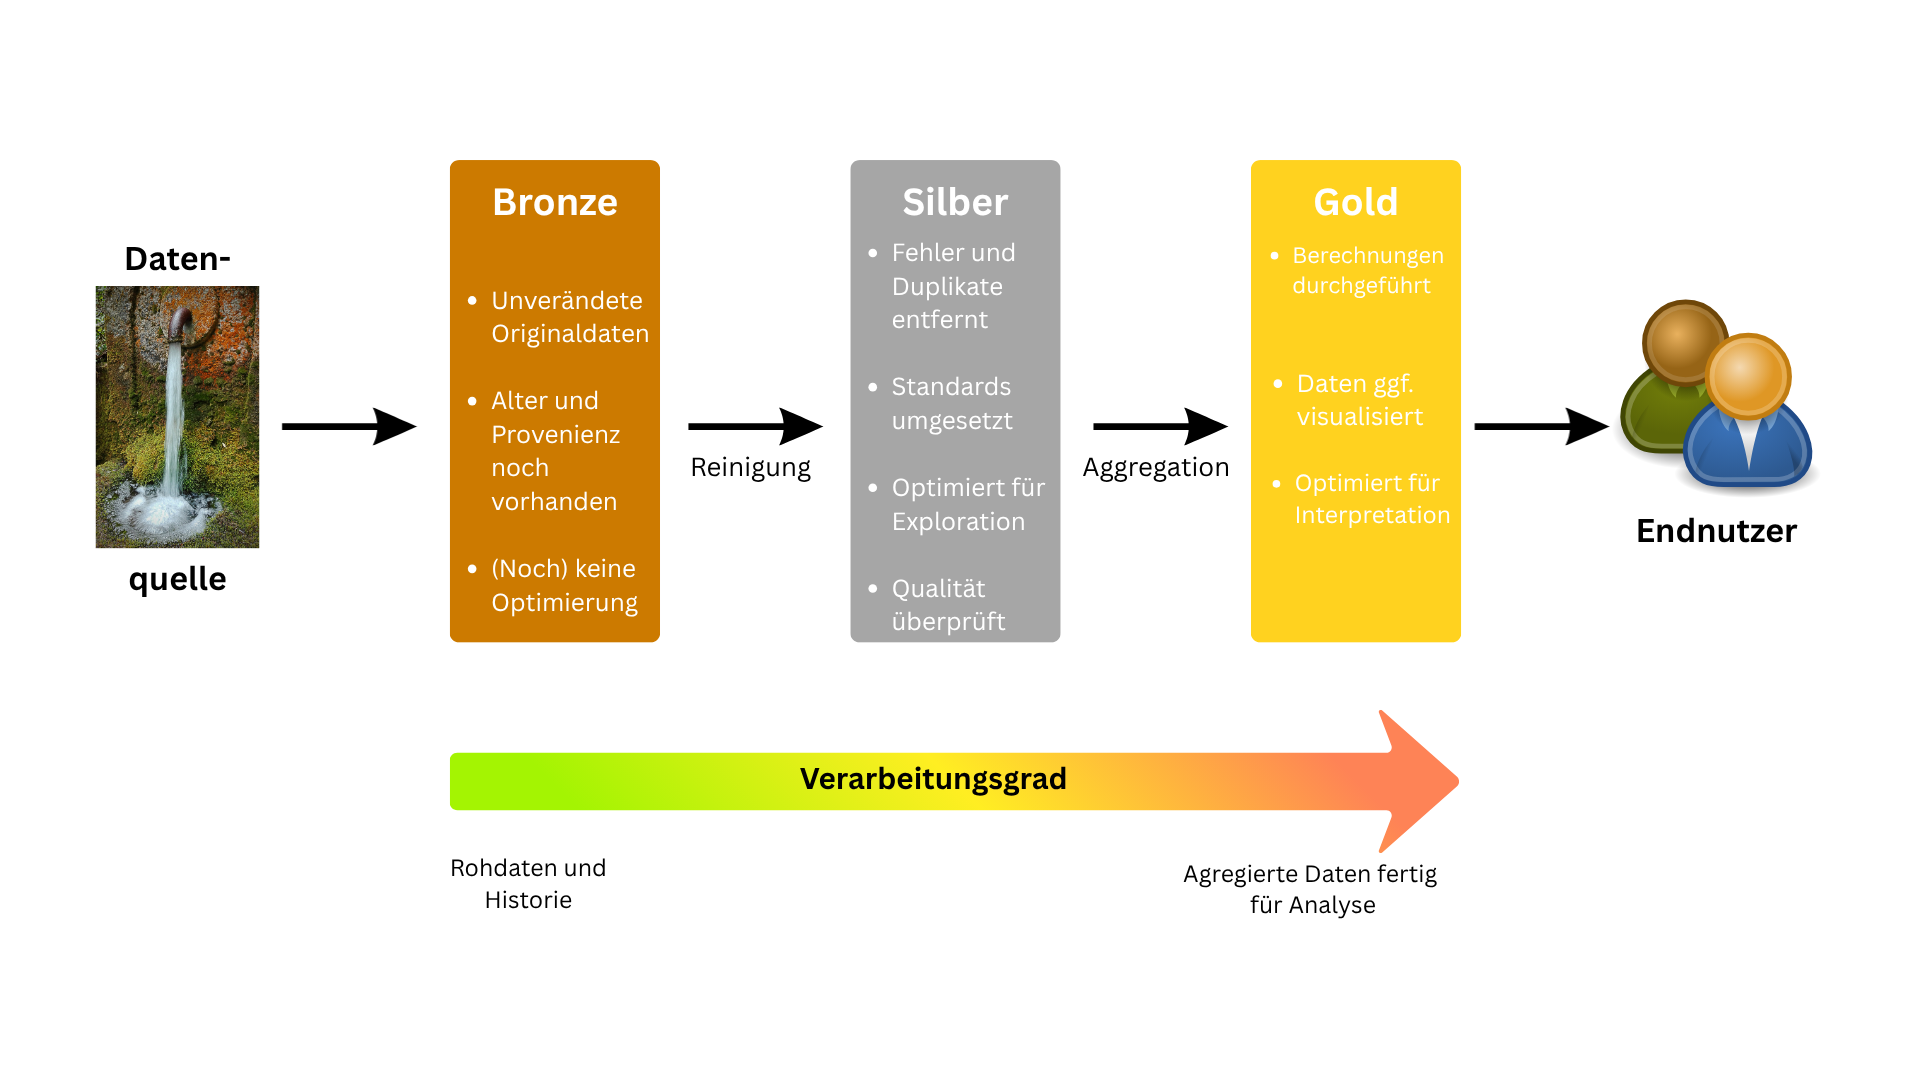
Abb. 2.4 Visualisierung des Medaillon Schemas#
Das Medaillon-Schema ist ein im Data Engineering verbreitetes Schichtenmodell zur strukturierten Verarbeitung und schrittweisen Aufbereitung von Daten. Dabei werden Daten aus einer Rohdatenquelle über mehrere Verarbeitungsstufen hinweg in einen zunehmend bereinigten, geprüften und für die Analyse aufbereiteten Zustand überführt. Die Bezeichnung orientiert sich an den drei Stufen Bronze, Silber und Gold.
Auf der Bronze-Stufe werden die Daten zunächst möglichst unverändert aus ihren ursprünglichen Quellen übernommen. Ziel ist es, die Rohdaten sowie ihre ursprüngliche Struktur und Historie zu erhalten. In dieser Stufe stehen daher weniger die unmittelbare Nutzbarkeit für Analysen als vielmehr die Nachvollziehbarkeit und Bewahrung der ursprünglichen Daten im Vordergrund. Informationen zur Datenherkunft und zum Zeitpunkt der Erfassung können dabei ebenfalls erhalten bleiben.
Anschließend werden die Daten auf der Silber-Stufe bereinigt und überprüft. Fehlerhafte oder doppelte Datensätze können entfernt, uneinheitliche Formate vereinheitlicht und festgelegte Standards umgesetzt werden. Zudem werden die Daten hinsichtlich ihrer Qualität geprüft. Dadurch entsteht ein konsistenterer Datenbestand, der sich insbesondere für die weitere Exploration und Verarbeitung eignet. Datenqualitätstests, beispielsweise zur Vollständigkeit, Gültigkeit oder Eindeutigkeit, können dabei eingesetzt werden, um fehlerhafte Daten frühzeitig zu erkennen.
Auf der Gold-Stufe werden die Daten schließlich gezielt für konkrete Analyse- und Anwendungsszenarien aufbereitet. Dazu können Daten aggregiert, Kennzahlen berechnet oder geeignete Darstellungen für die Analyse und Visualisierung erzeugt werden. Während die Bronze- und Silber-Stufen somit vor allem die Erhaltung und Verbesserung der Datenqualität unterstützen, steht auf der Gold-Stufe die fachliche Nutzbarkeit und Interpretation der Daten im Vordergrund [Armbrust et al., 2020, Mohna et al., 2022].
Obwohl die Bezeichnung Medaillon-Schema in der Forschungspraxis nicht üblich ist, besteht eine Verbindung zu Konzepten des Forschungsdatenmanagements und der Open Science. In der Forschung wird insbesondere die Datenprovenienz (eng. Data Provenance) dokumentiert, um nachvollziehbar zu machen, aus welchen Quellen genutzte Daten stammen und welche Verarbeitungsschritte zu einem wissenschaftlichen Ergebnis geführt haben. Die Dokumentation solcher Verarbeitungsschritte ist zugleich eine wichtige Voraussetzung für reproduzierbare Forschung, da Ergebnisse nicht allein von den Ausgangsdaten, sondern auch von deren Aufbereitung, verwendeten Programmen, Parametern und weiteren Verarbeitungsschritten abhängen.
Ein mögliches Problem in der Wissenschaftspraxis besteht darin, dass bei einer Veröffentlichung vor allem die finalen, für die Analyse verwendeten Daten und Ergebnisse sichtbar sind. Sind die zugrunde liegenden Ausgangsdaten und Verarbeitungsschritte nicht ausreichend dokumentiert, wird es schwieriger nachzuvollziehen, wie aus den ursprünglichen Daten die veröffentlichten Ergebnisse entstanden sind. Eine gute Forschungsdatenpraxis sollte daher neben den relevanten Daten auch deren Verarbeitung und (sofern verwendet und rechtlich möglich) den zugehörigen Code dokumentieren und möglichst dauerhaft über ein Repositorium zugänglich machen [Max Planck Digital Library, n.d.].
2.2.3. Strukturierung von Forschungsdaten#
Neben der Prüfung einzelner Werte ist auch die strukturelle Gestaltung eines Datensatzes für dessen Qualität und Nachnutzbarkeit von Bedeutung. Eine konsistente Datenstruktur erleichtert insbesondere die maschinelle Verarbeitung und die Verknüpfung verschiedener Datensätze. Dazu sollten Variablen einheitlich benannt und formatiert sowie eindeutige Identifikatoren verwendet werden. Auch fehlende Werte sollten nach einem einheitlichen Schema gekennzeichnet und Formate, beispielsweise für Datumsangaben, konsequent eingehalten werden. Eine häufig empfohlene Struktur ist dabei das sogenannte Tidy-Data-Prinzip: Jede Variable wird in einer eigenen Spalte, jede Beobachtung in einer eigenen Zeile und jeder einzelne Wert eindeutig einer Variable und einer Beobachtung zugeordnet. Dadurch wird eine konsistente Weiterverarbeitung und Auswertung der Daten erleichtert. Insbesondere in Rohdatensätzen sollten zudem keine Berechnungen oder rein visuellen Formatierungen vorgenommen werden, da diese die maschinelle Weiterverarbeitung erschweren können. Detailliertere Informationen finden Sie hier.
2.2.4. Praktische Umsetzung#
Die beschriebenen Qualitäts- und Strukturprüfungen können grundsätzlich selbst als automatisierte Skripte implementiert werden. Besonders geeignet sind hierfür Programmiersprachen wie Python, mit denen beispielsweise Wertebereiche, Datentypen, fehlende Werte, Duplikate oder die Einhaltung bestimmter Formate systematisch überprüft werden können. Solche Prüfungen lassen sich wiederholt auf einen Datensatz anwenden und dadurch reproduzierbarer und weniger fehleranfällig gestalten als eine ausschließlich manuelle Kontrolle. Für viele Anwendungsfälle existieren darüber hinaus spezialisierte Werkzeuge, die solche Prüfungen vereinfachen oder um zusätzliche Funktionen ergänzen [Fowler et al., 2017, Wickham, 2014].
Eine Übersicht verschiedener Werkzeuge für die Datenqualitätsprüfung bietet beispielsweise die Zusammenstellung von Tools for Data. Die dort aufgeführten Werkzeuge lassen sich unter anderem den Bereichen Data Testing, Data Observability, Data Lineage und Data Catalog zuordnen.
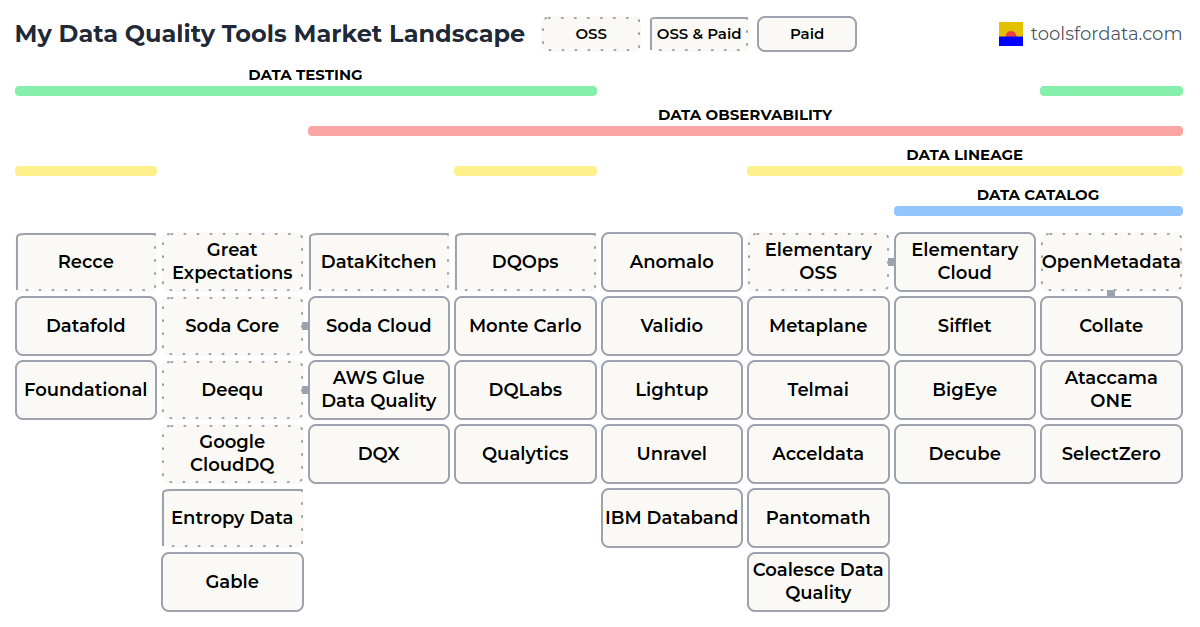
Abb. 2.5 Übersicht von Datenqualitätstools auf dem Markt (Quelle: https://toolsfordata.com/lists/data-quality-tools/ abgerufen am 02.09.2026)#
Unter Data Testing werden Werkzeuge zusammengefasst, mit denen konkrete Regeln und Erwartungen an Daten überprüft werden, beispielsweise ob eine Spalte ausschließlich gültige Werte enthält oder keine Duplikate aufweist.
Data Observability erweitert diesen Ansatz um die fortlaufende Überwachung von Daten und die Erkennung von Anomalien, beispielsweise ungewöhnlichen Veränderungen in Datenbeständen.
Data Lineage beschreibt hingegen die Nachverfolgung, aus welchen Quellen Daten stammen und welche Verarbeitungsschritte zwischen den verschiedenen Datenständen durchgeführt wurden.
Ein Data Catalog dient schließlich dazu, Datenbestände und die zugehörigen Metadaten systematisch zu erfassen, auffindbar zu machen und zu dokumentieren [Tools for Data, 2026].
Ein Beispiel für ein Open-Source-Werkzeug aus dem Bereich Data Testing ist Great Expectations. Dabei handelt es sich um eine Python-Bibliothek, mit der Erwartungen an die Struktur und den Inhalt von Daten formuliert und automatisiert überprüft werden können. So lässt sich beispielsweise festlegen, dass eine Spalte einen bestimmten Datentyp besitzen, keine fehlenden Werte enthalten oder nur Werte innerhalb eines vorgegebenen Bereichs aufweisen darf. Great Expectations kann dabei unter anderem auf Dateien, Datenbanken und DataFrames angewendet werden [Great Expectations, n.d.].
Neben solchen codebasierten Verfahren gibt es auch Werkzeuge, die eine Datenbereinigung über eine grafische Benutzeroberfläche ermöglichen. Ein Beispiel hierfür ist OpenRefine, eine Open-Source-Software zur Bereinigung, Formatierung und Anreicherung von Datensätzen. Die tabellarische Oberfläche erinnert an eine Tabellenkalkulation, bietet jedoch weitergehende Funktionen zur systematischen Bearbeitung größerer Datensätze. OpenRefine kann unter anderem verschiedene Dateiformate einlesen und eignet sich insbesondere zur Standardisierung und Bereinigung bereits vorhandener, unstrukturierter oder inkonsistenter Daten [OpenRefine Project, n.d.].
Die praktische Anwendung lässt sich anhand der von QUADRIGA bereitgestellten Fallstudie zu studentischen Filmen der Filmuniversität Babelsberg nachvollziehen. Dort wird OpenRefine eingesetzt, um einen bestehenden Datensatz schrittweise zu sichten und zu bereinigen. Unter anderem werden Spalten und Einträge bereinigt und Jahresangaben sowie Filmtitel standardisiert. Die Fallstudie zeigt damit exemplarisch, wie die zuvor beschriebenen Anforderungen an Konsistenz, Standardisierung und Nachnutzbarkeit in einem konkreten Forschungsdatensatz umgesetzt werden können.
Lösung Die Daten müssen händisch und stichprobenartig geprüft werden. Können wir hier mit Software zur Qualitätsprüfung arbeiten?
Folgende Fragen können dabei helfen:
genügen die Daten in der Art und Weise wie sie vorliegen den Ansprüchen (an GwP (welche Punkte genau?), Vollständigkeit, Plausibilität etc.)
Sind die Daten vollständig oder sind Lücken ersichtlich? Sind das nicht Fragen der Datenerhebung und Validierung? Wie prüfe ich das bei mir fremden, mglw. fachfremden Daten (es lassen sich doch nur übliche Lücken und Fehler erkennen)
Sind die Metadaten aussagekräftig und die Daten gut dokumentiert?
Bei der Einarbeitung in ein Projekt entsteht in der Regel automatisch ein Bild von möglichen Fragestellungen, Methodiken, Analysen und Ergebnissen. Diese Fragen können genutzt werden, um die Daten auf ihre Qualität zu prüfen.
2.2.5. Beispiel Szenario#
In dem in diesem Szenario abgebildeten Fall ist eine Qualitätsprüfung nicht notwendig gewesen, weil die Daten bereits gut aufgearbeitet vorlagen.
2.2.6. Learnings (generisch)#
Die inhaltliche Überprüfung der Datenqualität ist für Fachfremde durchaus herausfordernd. Daher hilft es, sich an den in diesem Unterkapitel genannten, allgemeinen Kriterien zur Prüfung von Datenqualität zu orientieren.
weiterdenken: was passiert, wenn die Daten nicht den Ansprüchen genügen? Sollten sie dann aufbereitet werden? Oder entfallen dann alle Schritte und ein nachträgliches Publizieren ist nicht möglich?
Literatur
Michael Armbrust, Tathagata Das, Liwen Sun, Burak Yavuz, Shixiong Zhu, Mukul Murthy, Joseph Torres, Herman van Hovell, Adrian Ionescu, Alicja Łuszczak, Micha\protect ł Świtakowski, Micha\protect ł Szafrański, Xiao Li, Takuya Ueshin, Mostafa Mokhtar, Peter Boncz, Ali Ghodsi, Sameer Paranjpye, Pieter Senster, Reynold Xin, and Matei Zaharia. Delta lake: high-performance acid table storage over cloud object stores. Proceedings of the VLDB Endowment, 13(12):3411–3424, 2020. doi:10.14778/3415478.3415560.
Li Cai and Yangyong Zhu. The challenges of data quality and data quality assessment in the big data era. Data Science Journal, 14(2):1–10, 2015. doi:10.5334/dsj-2015-002.
Dan Fowler, Jo Barratt, and Paul Walsh. Frictionless data: making research data quality visible. International Journal of Digital Curation, 12(2):274–285, 2017. doi:10.2218/ijdc.v12i2.577.
Hosne Ara Mohna, Tonmoy Barua, Mohammad Mohiuddin, and Md Mostafizur Rahman. Ai-ready data engineering pipelines: a review of medallion architecture and cloud-based integration models. American Journal of Scholarly Research and Innovation, 1(1):319–350, 2022. doi:10.63125/51kxtf08.
Anandhi Ramasamy and Soumitra Chowdhury. Big data quality dimensions: a systematic literature review. Journal of Information Systems and Technology Management, 17:e202017003, 2020. doi:10.4301/S1807-1775202017003.
Hadley Wickham. Tidy data. Journal of Statistical Software, 59(10):1–23, 2014. doi:10.18637/jss.v059.i10.
Great Expectations. Gx core: open source data quality platform. Open Source Data Quality Platform. URL: https://greatexpectations.io/.
Max Planck Digital Library. Data quality – research data management. Information Platform for Max Planck Researchers. URL: https://rdm.mpdl.mpg.de/before-research/data-quality/.
OpenRefine Project. Openrefine: a power tool for working with messy data. Open Source Tool for Data Cleaning. URL: https://openrefine.org/.
Tools for Data. 36 best data quality tools in 2026. 2026. Blog-Beitrag auf Tools for Data. URL: https://toolsfordata.com/.