3.2. Erschließung#
Dieses Unterkapitel fokussiert die Kompetenz „3.2 Erschließung“ des QUADRIGA Datenkompetenzframeworks. Dies umfasst die an Standards orientierte Auszeichnung bzw. Beschreibung von Daten.
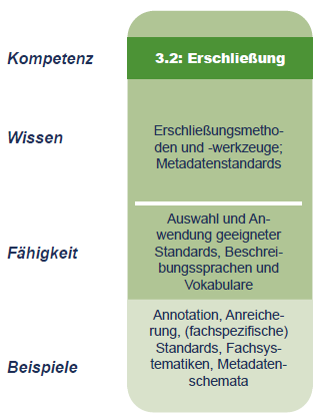
Abb. 3.7 Die Kompetenz 3.2 Erschließung des QUADRIGA Datenkompetenzframeworks.#
Quellenangabe: Ausschnitt aus dem Modell „QUADRIGA Datenkompetenzframework“ von Petras et al. unter der Lizenz CC BY 4.0 via Zenodo.
3.2.1. Ausgangslage#
Im Rahmen der Erschließung der Daten, müssen Metadaten vergeben werden, wenn das an anderer Stelle noch nicht geschehen ist. Dies sollte nach den Konventionen der Disziplin geschehen, aus der die Forschungsdaten stammen.
Die Daten und Metadaten sollten eine FAIRifizierung durchlaufen, d. h. möglichst vollständig beschrieben werden. Dazu sollte, wo es möglich ist, auf Standards zurückgegriffen und Interoperabilität hergestellt werden.
Auch eine README gehört zu einer guten Datenbeschreibung. Darin sollten Sie alles dokumentieren, was Nachnutzende über die Daten wissen sollten.
3.2.2. Vorgehen#
Metadaten
Recherchieren Sie, ob es disziplinspezifische Vorgaben für Metadaten gibt. Ein Übersicht über internationale Standards finden Sie beispielsweise:
im Metadata Standards Catalog der englischen Universität Bath
auf der Webseite von FAIRsharing
Die folgende Übersicht zeigt zudem beispielhaft einige etablierte Metadatenstandards verschiedener Fachdisziplinen.
Disziplin |
Metadatenstandard |
Organisation |
Quelle |
|---|---|---|---|
Fachübergreifend |
DataCite Metadata Schema |
DataCite |
|
— |
— |
— |
— |
Astronomie |
IVOA Technical Specifications |
IVOA |
|
Bauwesen/Stadtplanung |
XPlanung (ergänzt durch XBau) |
XLeitstelle |
|
Biodiversität |
Darwin Core |
TDWG |
|
Geisteswissenschaften |
TEI (Text Encoding Initiative) |
TEI Consortium |
|
Geodaten |
ISO 19115 |
ISO |
|
Klimaforschung |
CF Conventions |
CF Conventions Community |
|
Kulturerbe |
CIDOC CRM |
CIDOC CRM SIG / ISO |
|
Medizin |
CDISC (u. a. CDASH, SDTM, ODM) |
CDISC |
|
Sozialwissenschaften |
DDI (Data Documentation Initiative) |
DDI Alliance |
Darüber hinaus finden Sie Informationen zu fachspezifischen Standards bei den Konsortien der Nationalen Forschungsdaten Infrastruktur (NFDI) sowie deren Sektion (Meta)data, Terminolgies, Provenance.
FAIRifizierung
Für die FAIRifizierung von Daten ist vor allem die Vergabe eines Persistenten Identifikators (PID), beispielsweise eines Digital Object Identifiers (DOI) von Bedeutung. Diesen erhalten Sie in der Regel automatisch von dem Repositorium, in dem Sie Ihre Forschungsdaten veröffentlichen wollen (s. Kapitel 4 Publikation). Prüfen Sie darüber hinaus, ob die Beschreibung der Daten vollständig ist und maximieren Sie nach Möglichkeit die Interoperabilität der Daten. Recherchieren Sie, was standardisiert beschrieben werden kann (z. B. nach ISO).
Weitere Informationen
Die FAIRifizierung von Forschungsdaten kann sowohl mithilfe von Checklisten und Reifegradmodellen als auch mit automatisierten Prüfwerkzeugen unterstützt werden. Eine ausführliche Einführung in die FAIR-Prinzipien sowie weitere Hintergrundinformationen finden Sie in dem Kapitel 3.1 „FAIR-Prinzipien“ der QUADRIGA-OER Reproduzierbarkeit von Datenanalysen: Ein Fallbeispiel aus dem Nationalen Bildungsbericht. Dort werden unter anderem folgende Ansätze vorgestellt:
Checkliste: eine kompakte FAIR-Checkliste von Jones und Grootveld (2017)
Webtool: das deutschsprachige FAIR Assessment Tool des Thüringer Kompetenznetzwerks Forschungsdatenmanagement (TKFDM), basierend auf dem FAIR Assessment Tool der Australian Research Data Commons
FAIR Data Maturity Model: das detaillierte Reifegradmodell der Research Data Alliance (RDA), auf Deutsch verfügbar über das Projekt EcoDM
Neben manuellen Checklisten und Reifegradmodellen stehen auch automatisierte Prüfwerkzeuge zur Verfügung. Diese bewerten die FAIRness eines Datensatzes anhand eines Persistent Identifiers (PID) oder einer URL und geben unmittelbar Rückmeldung darüber, welche FAIR-Kriterien bereits erfüllt sind und wo Verbesserungsbedarf besteht.
F-UJI – automatische FAIR-Bewertung anhand eines PID oder einer URL
FAIR-Checker – automatische Analyse der FAIR-Metadaten eines Datensatzes
FAIR-Aware – unterstützt Forschende bei der Selbstbewertung anhand eines kurzen Fragenkatalogs
README
Eine README-Datei ist die einfachste Form der Datendokumentation und soll sicherstellen, dass Daten auch später oder von anderen Personen korrekt interpretiert werden können [Hassenstein and Jung, 2025]. Sie sollte einer Datenpublikation als einfache Datei im Format .txt beigelegt werden. Alternativ können Sie die Daten im Repositorium beschreiben, wenn das möglich ist.
Die folgende Vorlage kann als Orientierung für den Aufbau einer README-Datei dienen.
Beispiel: Vorlage für eine README-Datei
ALLGEMEINE INFORMATIONEN
Titel des Projekts
Autor:innen und Kontaktinformationen
Zeitraum und Ort der Datenerhebung
Angaben zum Förderprojekt
WEITERGABE UND ZUGANG
Lizenz
Empfohlene Zitierweise
Zugehörige Publikationen
DATEN- UND DATEIÜBERSICHT
Beschreibung der Dateien
Datei- und Ordnerstruktur
Versionen
METHODISCHE INFORMATIONEN
Datenerhebung
Datenverarbeitung
Verwendete Software
Qualitätssicherung
DATEISPEZIFISCHE INFORMATIONEN
Variablen
Fehlende Werte
Besonderheiten
Vorlage aus dem Englischen übersetzt und gekürzt nach [UCSB Library Research Data Services, 2024] (CC BY 4.0).
Als ergänzende Hilfestellung stellt Cornell Data Services eine ausführliche Anleitung sowie eine frei verfügbare Vorlage für README-Dateien bereit.
Weitere Materialien
Vor allem die Methodischen Informationen variieren naturgemäß stark zwischen den Fachrichtungen. Einzelne NFDI-Konsortien haben daher eigene Tempaltes für READMEs erstellt, so zum Beispiel die NFDI4Chem.
Literatur
Max J. Hassenstein and Klaus Jung. Ten simple rules for effective research data management. PLOS Computational Biology, 21(12):e1013779, 2025. doi:10.1371/journal.pcbi.1013779.
John Wieczorek, David Bloom, Robert Guralnick, Stan Blum, Markus Döring, Renato Giovanni, Tim Robertson, and David Vieglais. Darwin core: an evolving community-developed biodiversity data standard. PLOS ONE, 7(1):e29715, 2012. doi:10.1371/journal.pone.0029715.
CDISC. Cdisc standards (u. a. cdash, sdtm, odm). 2026. Webseite ohne Datumsangabe, zuletzt abgerufen 2026. URL: https://www.cdisc.org/.
CF Conventions Community. Netcdf climate and forecast (cf) metadata conventions. 2026. Webseite ohne Datumsangabe, zuletzt abgerufen 2026. URL: https://cfconventions.org/cf-conventions/cf-conventions.html.
DataCite Metadata Working Group. Datacite metadata schema for the publication and citation of research data and other research outputs, version 4.7. Technical Report, DataCite, 2026. URL: https://schema.datacite.org/, doi:10.14454/qdd3-ps68.
DDI Alliance. Data documentation initiative (ddi). 2026. Webseite ohne Datumsangabe, zuletzt abgerufen 2026. URL: https://ddialliance.org/.
International Organization for Standardization. Iso 19115-1:2014 – geographic information – metadata – part 1: fundamentals. Technical Report, ISO, 2014. URL: https://www.iso.org/standard/53798.html.
International Organization for Standardization. Iso 21127:2023 – information and documentation – a reference ontology for the interchange of cultural heritage information. Technical Report, ISO, 2023. URL: https://www.iso.org/standard/85100.html.
International Virtual Observatory Alliance. Ivoa technical specifications. 2026. Webseite ohne Datumsangabe, zuletzt abgerufen 2026. URL: https://www.ivoa.net/.
TEI Consortium. Tei: text encoding initiative guidelines. 2026. Webseite ohne Datumsangabe, zuletzt abgerufen 2026. URL: https://tei-c.org/.
UCSB Library Research Data Services. Readme template. 2024. URL: https://zenodo.org/records/10828379, doi:10.5281/zenodo.10828379.
XLeitstelle. Handreichung zu xplanung und xbau. Technical Report, XLeitstelle Hamburg, 2018. Verbindliche Einführung von XPlanung und XBau durch Beschluss des IT-Planungsrats am 5. Oktober 2017. URL: https://xleitstelle.de/downloads/Handreichung_XPlanung-XBau_2_Auflage.pdf.