3.1. Organisation#
Dieses Unterkapitel bezieht sich auf die Kompetenz „3.1 Organisation“ des QUADRIGA Datenkompetenzframeworks - wie Abb. 3.3 zeigt.
Das bedeutet, dass die im Projekt entstandenen Forschungsdaten an dieser Stelle geordnet und organisiert werden müssen, sodass sie auch projekt-extern bzw. interdisziplinär verstanden werden. Wenn im Lauf des Projektes noch kein Datenmanagementplan (DMP) begonnen wurde, muss nun einer angelegt werden.
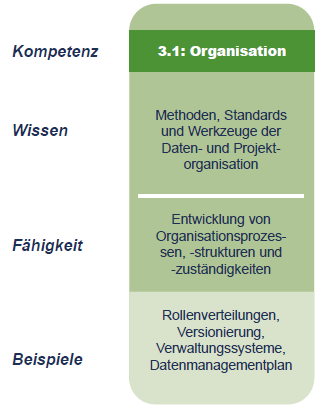
Abb. 3.3 Die Kompetenz 3.1 Organisation des QUADRIGA Datenkompetenzframeworks.#
Quellenangabe: Ausschnitt aus dem Modell „QUADRIGA Datenkompetenzframework“ von Petras et al. unter der Lizenz CC BY 4.0 via Zenodo.
3.1.1. Ausgangslage#
Die Daten müssen vor der Publikation geordnet und strukturiert werden. Zuerst müssen dazu jene Daten ausgewählt werden, die veröffentlicht werden sollen. Je nach Umfang sollten diese zudem geclustert werden. Darüber hinaus muss die Benennung der Daten und Dateien geprüft werden. Sind sie bereits nach einem (erkennbaren) Schema benannt? Wenn nicht, sollte das erwogen werden. Zudem sollten die Dateiformate geprüft werden: Liegen sie in proprietären Formaten vor oder nicht? Ist es sinnvoll, sie zu konvertieren, wenn sie in proprietären Formaten vorliegen? Dabei ist es hilfreich sich zu fragen, ob die Daten so strukturiert und benannt sind, dass sie für Außenstehende verständlich sind.
3.1.2. Vorgehen#
Es empfiehlt sich, die Daten so zu ordnen, dass sie auch interdisziplinär bzw. projekt-extern verstanden werden. Fügen Sie Daten zu sinnvollen Bündeln zusammen oder teilen Sie sie in solche auf. Bei der Custerung kann auch schon die Zusammenfassung in ZIP-Paketen mitgedacht werden. Diese Punkte müssen Sie bei der Anlage eines DMP ohnehin mitdenken.
Weitere Informationen
Das Rhein-Ruhr Zentrum für wissenschaftliche Datenqualität (DKZ.2R) hat ein so genanntes Cheat Sheet erstellt, auf dem wichtige Informationen zur Struktur und Benennung von Daten auf einer A4-Seite zusammengefasst sind.
Das oben genannte Datenmanagement wird durch das Verfassen eines DMP erreicht. Wie Sie einen DMP anlegen, wird Schritt für Schritt im folgenden Abschnitt anhand des Beispielszenarios gezeigt. Der DMP wird gemeinsam mit den Forschungsdaten veröffentlicht.
3.1.3. Beispielszenario#
Nochmal eingehen auf Auswahl und clusterung der daten Eingehen auf Datenbenennung
Im Beispielszenario ‚Q-LCA Forschungsdatenveröffentlichung‘ musste ein DMP nachträglich verfasst werden, weil während der Projektlaufzeit noch keiner angelegt wurde. Dazu wurde das Tool Research Data Management Organiser RDMO verwendet. Zu den Vorteilen von RDMO gehört, dass es in Deutschland entwickelt wurde und daher auf die spezifischen Förderbedingungen und die Rechtslage Bezug nehmen kann. Anhand eines Fragenkatalogs werden Aussagen über das Projekt und die darin entstandenen Forschungsdaten zusammengestellt und ein DMP angefertigt. Darüber hinaus können Werte importiert und der DMP in verschiedenen Formaten exportiert werden (s. weiter unten, Abb. 3.6).
Dieses Unterkapitel führt Sie durch das Anlegen eines DMP am Beispiel des DMP für das Projekt Q-LCA. Bitte beachten Sie: Um selbst einen DMP anzulegen, müssen Sie sich registrieren - z. B. für den Brandenburger RDMO-Dienst. Falls Sie sich nicht registrieren wollen oder können, werden Sie durch Beispielbilder trotzdem in der Lage sein, dem Erstellen eines Datenmanagementplans zu folgen.
Nach der Anmeldung erstellen Sie ein neues Projekt, indem Sie auf den entsprechenden Button klicken. Dieses muss benannt und ein Fragenkatalog ausgewählt werden (s. Abb. 3.4). Der Katalog DFG in der Version 5 sei dabei empfohlen, weil er die Leitlinien zum Umgang mit Forschungsdaten mit der Checkliste zum Umgang mit Forschungsdaten der DFG verbindet. Optional können Sie das Projekt zusätzlich einem übergeordneten Projekt zuweisen.
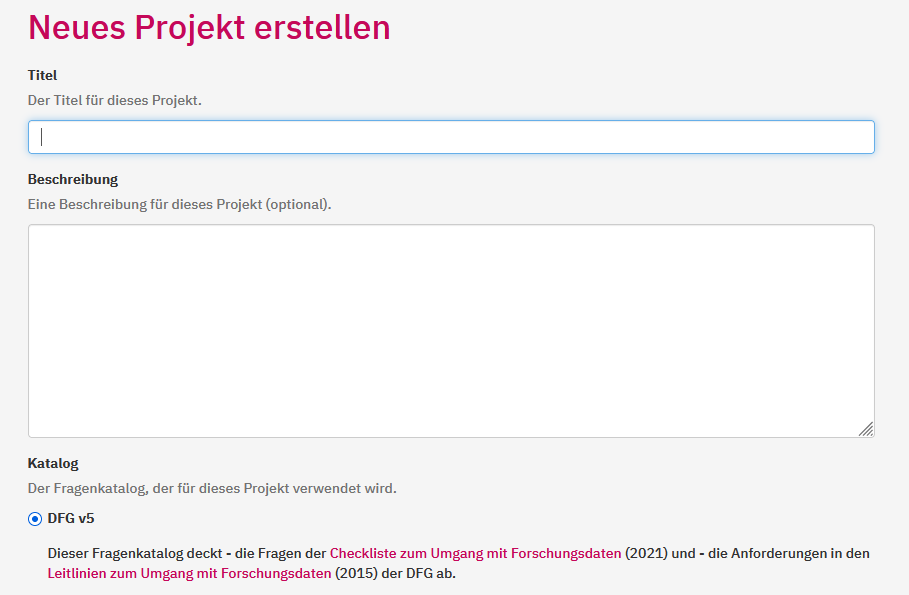
Abb. 3.4 Eingabemaske zum Anlegen eines neuen Projektes bei RDMO Brandenburg.#
Quellenangabe: Screenshot der Eingabemaske zum Anlegen eines neuen Projektes bei RDMO Brandenburg vom 09.10.2026.
Nachdem das Projekt angelegt wurde, müssen über den Button ‚Fragen beantworten‘ Aussagen zum Projekt und den im Projekt erhobenen Daten eingegeben werden (s. Abb. 3.5).
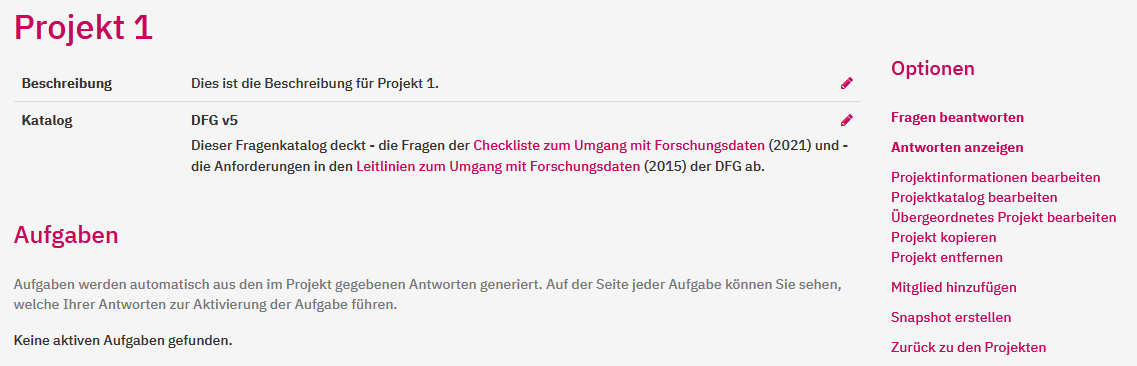
Abb. 3.5 Projektansicht mit dem Button ‚Fragen beantworten‘ oben rechts bei RDMO Brandenburg.#
Quellenangabe: Screenshot der Projektansicht bei RDMO Brandenburg vom 09.10.2026.
Anschließend fügen Sie die Datensätze hinzu, die im Projekt entstanden sind. Spätestens bei diesem Schritt kommt die Auswahl und Clusterung der Forschungsdaten zum Tragen. Es ist sinnvoll, sich bereits bei diesem Schritt zu überlegen, wie die Daten bereitgestellt werden sollen (z. B. als Gesamt-ZIP, in ZIP-„Paketen“ oder einzeln). Das hängt sehr stark von der Art der Forschungsdaten ab. Im Beispielszenario wurde sich für 4 Forschungsdatensätze entschieden, die auch so benannt wurden (FD1_… bis FD4_…). Diese Datensätze erscheinen in RDMO als Registerkarten bzw. Tabellenreiter. Praktischerweise ermöglicht das Tool RDMO die Übernahme von einmal eingegebenen Informationen zu anderen Datensätzen. Sie müssen also projektrelevante Informationen nicht mehrfach eingeben!
Hinweis
Die Benennung der Forschungsdaten ist nicht trivial. Überlegen Sie sich eine sinnvolle Ordnung und Zusammenstellung und behalten Sie diese bei. Das im DMP als „FD3_Bilanzierungstool“ bezeichnete Datum bzw. Datenpaket sollte auf der Veröffentlichungsplattform genauso heißen. Die Zusammenfassung von Forschungsdaten zu Paketen hat den Vorteil, dass Sie die Dateibenennung, die sich während des Projektes etabliert hat, nicht ändern müssen. So lassen sich beispielsweise verschiedene Screenshots in einem Paket „FD4_Screenshots“ zusammenfassen.
Übrigens: RDMO speichert Ihren Fortschritt. Sie müssen also nicht alles in einer Sitzung bearbeiten und fertigstellen.
Am Ende liegt ein Überblick über Ihre Daten vor, der je nach Fragenkatalog verschieden beschrieben ist. Diese sind nun übersichtlich gegliedert und lassen sich u. a. als PDF, Office Dokument oder Markdown Datei exportieren (s. Abb. 3.6).
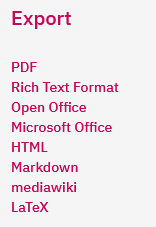
Abb. 3.6 Exportmöglichkeiten eines DMP bei RDMO Brandenburg.#
Quellenangabe: Screenshot der Exportmöglichkeiten eines DMP bei RDMO Brandenburg vom 09.10.2026.
3.1.4. Learnings#
Übernehmen Sie die Struktur der Daten soweit wie möglich aus dem Projekt. Diese ist in der Regel nicht ohne Grund entstanden und lässt sich durch eine Dokumentation auch nachvollziehen. Diese Struktur kann der Grundaufbau der Datenbereitstellung sein. Diese sollte egal ob als ZIP, Gesamt- oder Teil-ZIP eine logische Ordnung und Clusterung aufweisen.
In Bezug auf die Dateibenennung sollte beachtet werden, dass zwar einerseits eine verständliche Benennung sinnvoll ist, andererseits bei einer Umbenennung im Nachhinein Vorsicht geboten ist. Die Entwicklung von Dateibenennungen im Projekt folgt oft einer eigenen Logik und ein nachträgliches Umbenennen kann zu Verständigungsproblemen führen. Darüber hinaus ist diese sehr fehleranfällig. Es gilt also einen guten Mittelweg zu finden und eine einmal getroffene Entscheidung konsequent durchzuführen.
Zusätzliche Materialien
Video (Coffee Lecture) zur Erstellung eines Datenmanagementplans vom Thüringer Kompetenznetzwerks Forschungsdatenmanagement (TKFDM) via Youtube.
5-minütiges Video „Datenmanagement nach Plan“ von Schmitz et al. (2019) unter der Lizenz CC BY 4.0 via RWTH Aachen
Im nächsten Unterkapitel stehen Metadaten, die FAIRifizierung von Datensätzen und das Anlegen einer README-Datei im Fokus. Diese Aspekte können zwar auch Teil des DMP sein, gehören aber zur Kompetenz „Erschließung“.