3.1. Einführung Metadaten#
Metadaten sind Daten über Daten. Oder wie Johanna Drucker es treffend formuliert: “Think of metadata as the information about a resource or digital asset” (Drucker, 2021). Die Bandbreite der Erscheinungsformen von Metadaten reicht von sehr einfachen Beschreibungen, wie etwa den grundlegenden “Get Info”-Angaben zu einem digitalen Objekt, bis hin zu hochkomplexen Metadatenstrukturen mit mehreren Ebenen, Feldern und Hierarchien, wie sie insbesondere in Museen, kulturellen Einrichtungen und Archiven zur Erschließung und Verwaltung von Beständen genutzt werden (Drucker, 2021).
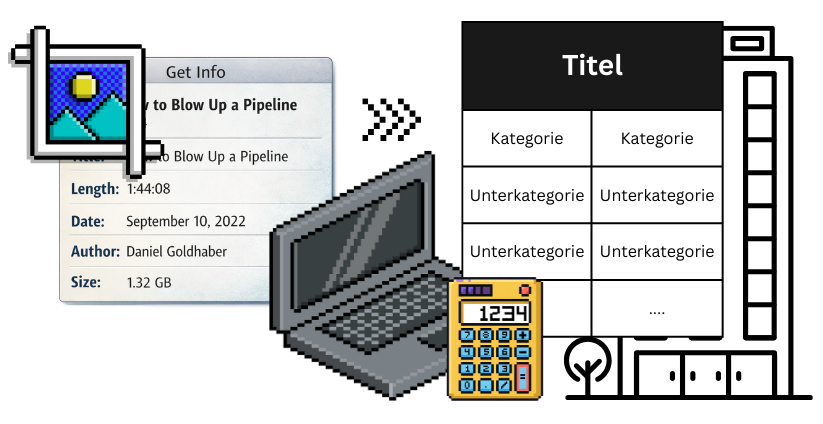
Als Bestandteil von Dateien und Dokumenten geben Metadaten im Kern zusätzliche, strukturierte Informationen an, die den eigentlichen (Forschungs-)Daten, Ressourcen oder Objekten, die sie beschreiben, beigefügt werden (Drucker, 2021, Freie Universität Berlin, o. J.). Häufig stehen die Metadaten aber auch als Platzhalter für das Objekt selbst, wie es beispielsweise in Bibliothekskatalogen der Fall ist. Hier wird das ursprüngliche Objekt (z. B. ein Buch oder Film) über Metadaten definiert und identifiziert, um Materialien zu lokalisieren und Informationen einzugrenzen. Auf diese Weise ermöglichen Metadaten die Beschreibung, Identifizierung und Klassifizierung von (digitalen) Objekten und kulturellen Artefakten.
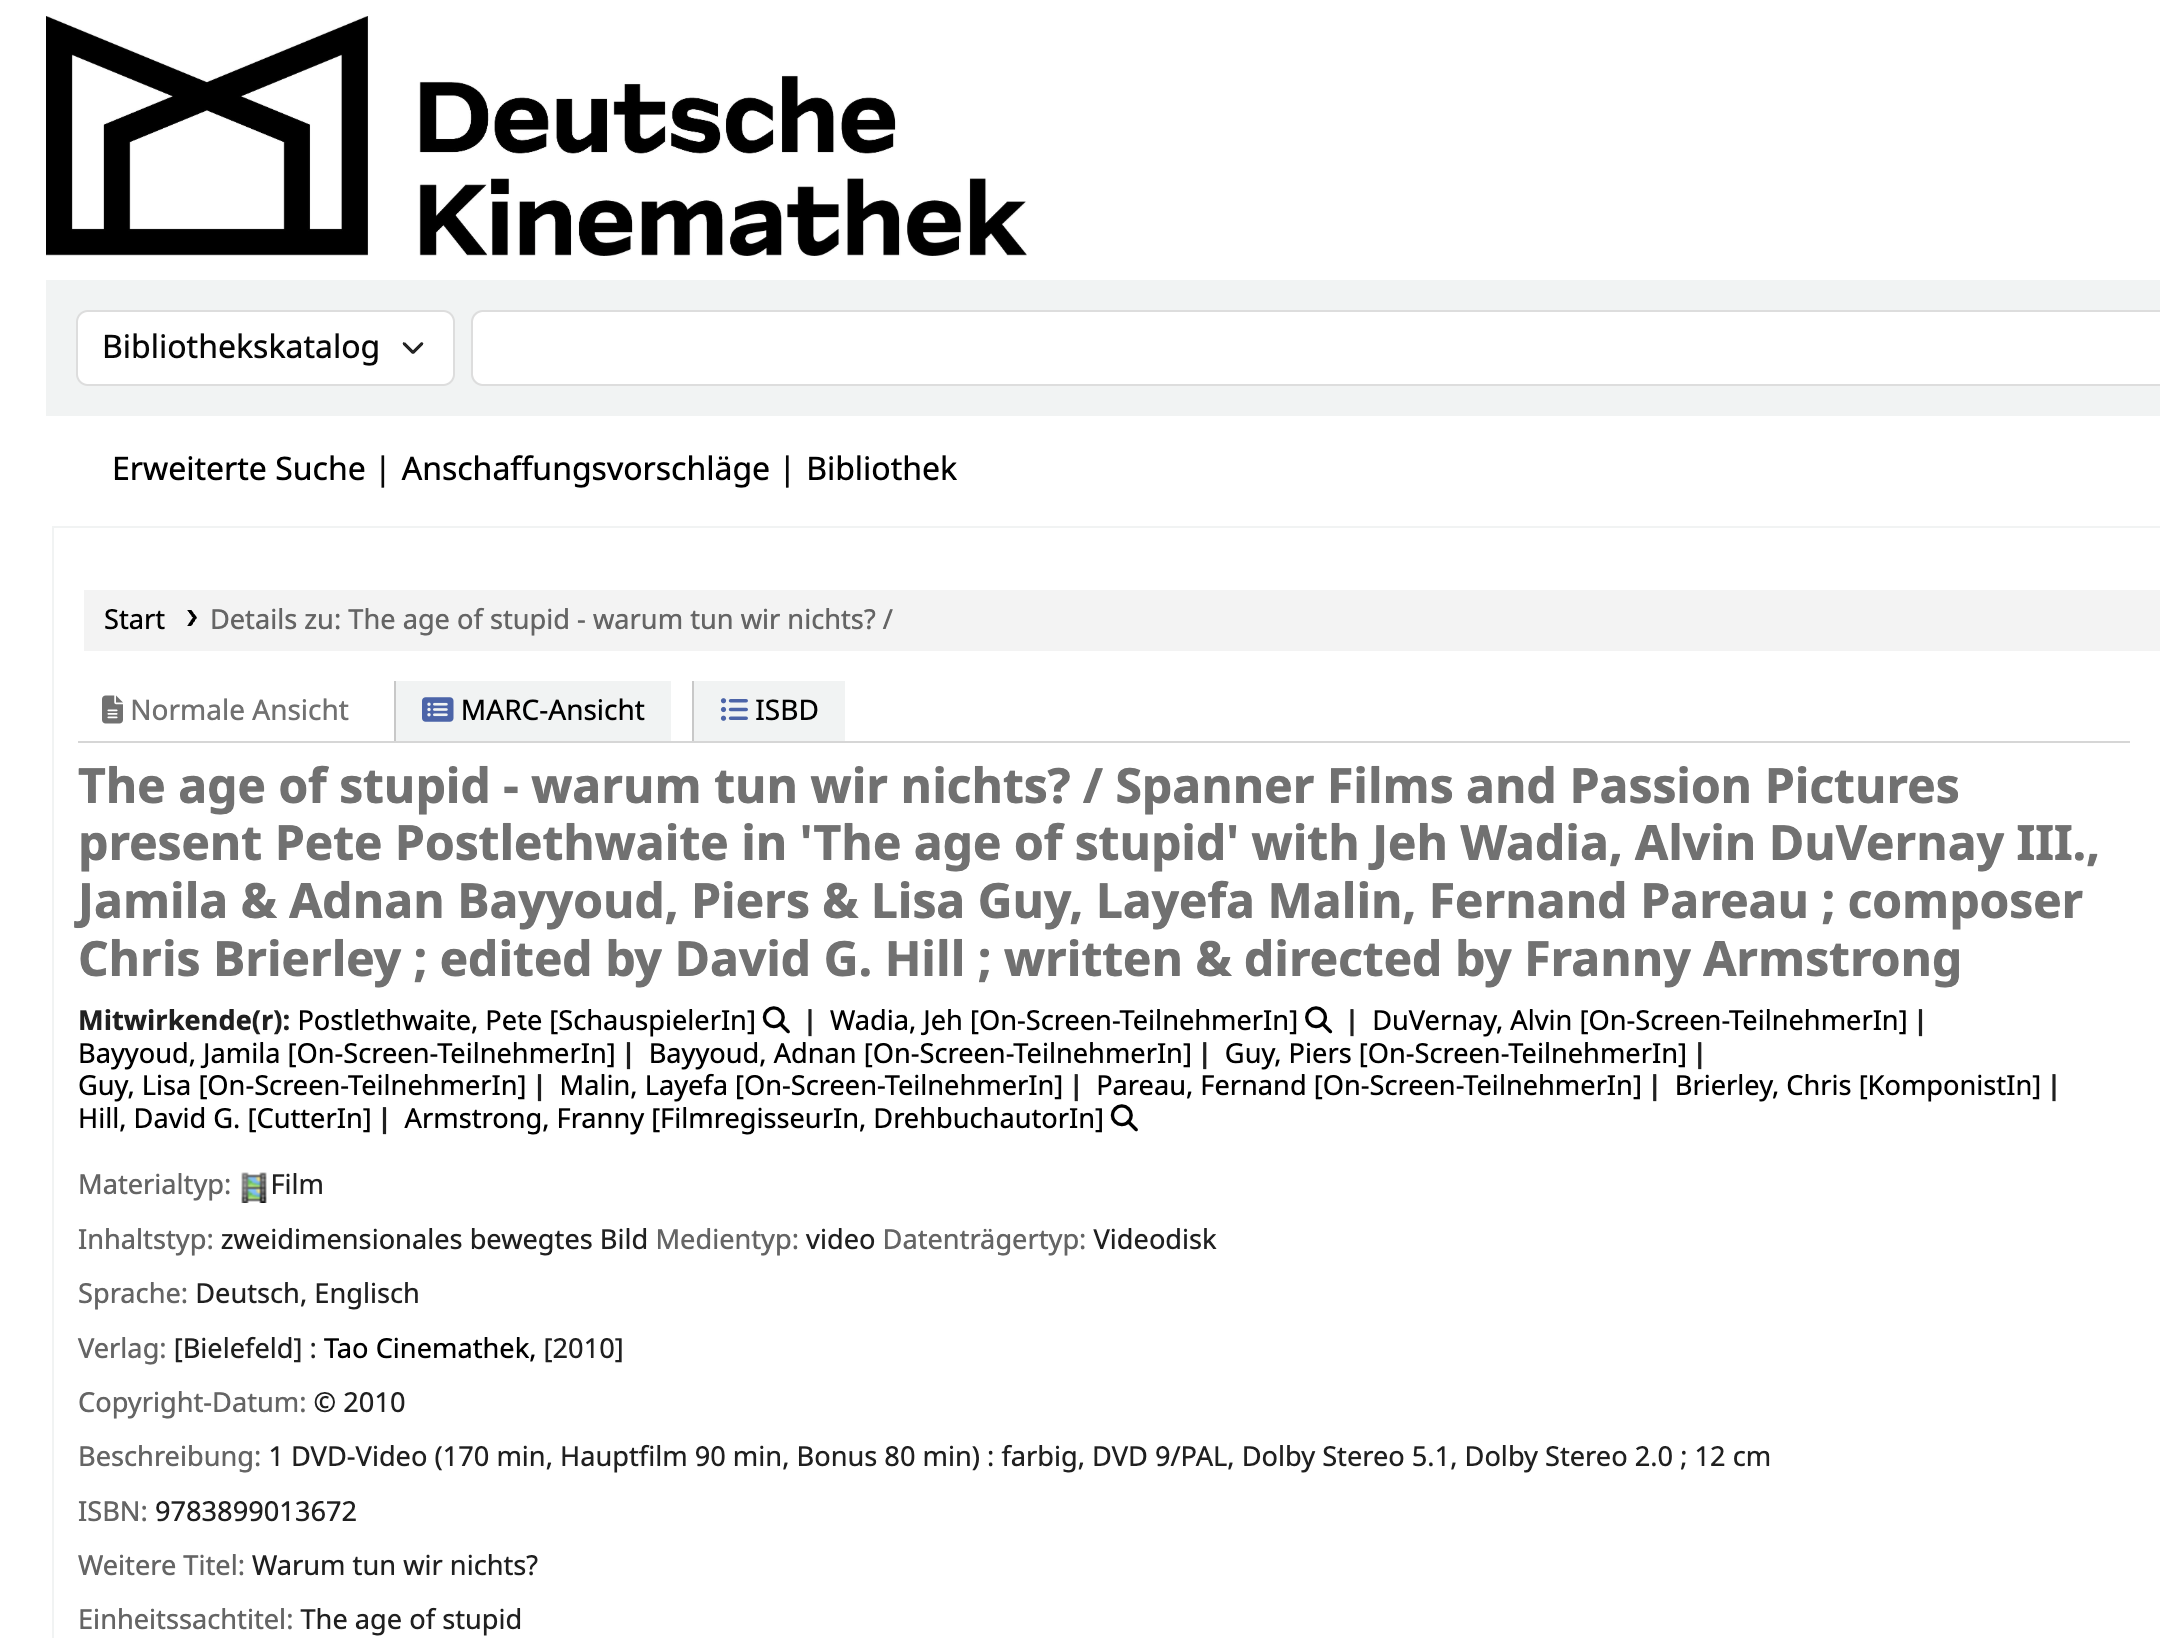
Fig. 3.3 Ergebnisansicht eines Bestandeintrags im Katalog der Deutschen Kinemathek Bibliothek#
Für die Publikation von Forschungsdaten sind Metadaten unerlässlich, da erst durch die ergänzenden Informationen Daten zuverlässig auffindbar, eindeutig identifizierbar und damit zitierfähig werden. Die zentrale Bedeutung von Metadaten in der digitalen Forschungspraxis hebt auch Drucker hervor:
“Metadata is an essential aspect of any digital scholarship or research. Data have to be described and identified in order to be useful.” (Drucker, 2021)
Die Charakterisierung von Daten über Metadaten ermöglicht es Forschenden somit, Daten in ihre jeweiligen Kontexte einzuordnen, ihre Herkunft und Struktur nachzuvollziehen und ihre Qualität zu bewerten (Dierkes, 2021).
Arten von Metadaten#
Es gibt verschiedene Typen von Metadaten, die hinsichtlich ihrer Art und Funktion unterschieden werden (vgl. hierzu auch Riley, 2017, Redaktion von forschungsdaten.info, 2026):
| Metadatentyp | Eigenschaften und Funktionen | Beispiele |
|---|---|---|
| Deskriptive (inhaltliche) bzw. bibliographische Metadaten | Helfen beim Auffinden oder Verstehen einer Ressource und bieten inhaltliche Eingrenzung | Titel, Autor, Beschreibung, Keywords, Publikationsdatum uvm. |
| Administrative Metadaten |
Helfen bei der Verwaltung und langfristigen Sicherung der Daten Unterarten:
|
Dateityp und -größe, Speicherort, Erstellungsdatum, Provenance, Zugriffsrechte, Lizenzen uvm. |
| Strukturelle Metadaten | Beschreiben die Anordnung und Hierarchie eines Objekts oder einer Sammlung, d. h. die Beziehung der einzelnen Teile zueinander | Kapitelstruktur eines Buchs, sequentielle Abfolge eines Films, Verlinkungsstrukturen einer Website, Codelisten uvm. |
| Prozessmetadaten | Dokumentieren die Schritte und Methoden, die zur Entstehung und Verwendung von Daten angewendet werden | Verarbeitungsschritte, Tools, Transformationen, Workflows, Versionsverlauf uvm. |
Nicht immer sind die einzelnen Metadaten-Kategorien klar voneinander zu trennen. So kann es beispielsweise Überlappungen zwischen Prozessmetadaten und administrativen Metadaten geben, wenn es um technische Beschreibungen wie Dateiformat, Erstellungsdatum oder Migration geht. Nichtsdestotrotz ist eine grundlegende Charakterisierung der Funktionen und Eigenschaften verschiedener Metadatentypen im Forschungsprozess sehr hilfreich.
Exkurs: Markup-Sprachen#
Metadaten liegen oft in maschinenlesbarer Form vor – in sogenannten Markup-Sprachen. Dies unterstützt die Interoperabilität der Daten hinsichtlich Weiterverwendung und Austausch.
Was sind Markup-Sprachen?
Markup-Sprachen (dt. Auszeichnungssprache) sind maschinenlesbare Sprachen. Sie strukturieren und formatieren Texte und Dateien, indem sie ihnen Eigenschaften - sogenannte tags - hinzufügen. Die bekannteste Markup-Sprache ist html (Wikipedia, 2026).
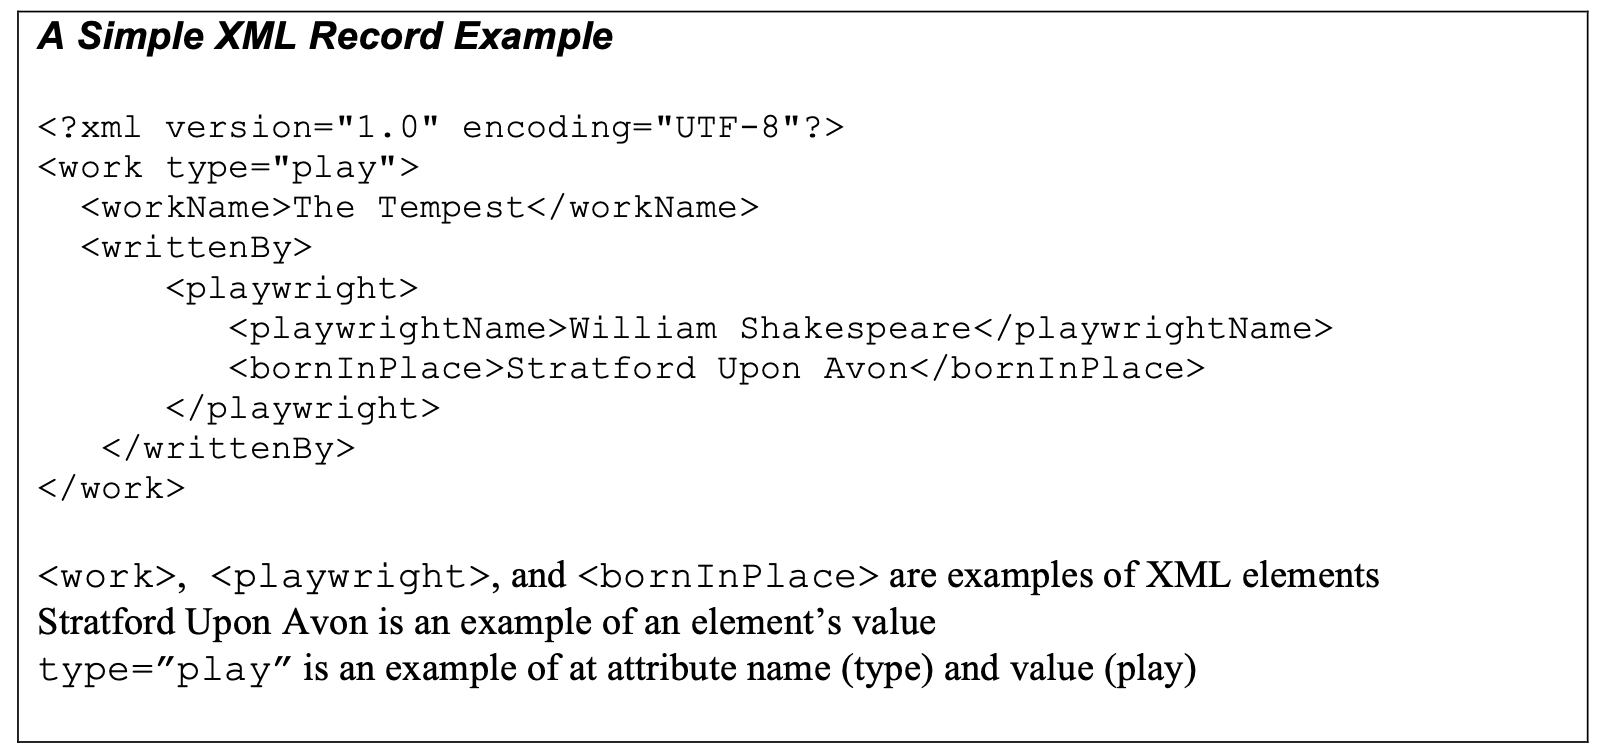
Am häufigsten wird dabei die Markup-Sprache xml verwendet. Metadaten liegen dann als Datensatz in einem xml-Dokument vor.
Wie funktioniert XML?
xml nutzt definierte Elemente bzw. Tags, um anzugeben, welche Bedeutung den jeweils enthaltenen Werten zukommt. Elemente können auch andere Elemente enthalten. Ein xml-Dokument ist ähnlich aufgebaut wie eine Baumstruktur, beginnend mit einem Stammelement (Riley, 2017).
In den Digital Humanities hat sich die auf xml basierte Markup-Sprache tei als gängiger Standard etabliert. tei wurde gezielt an die Bedürfnisse geisteswissenschaftlicher Forschung angepasst.
Mehr Informationen zu XML & TEI
Neben solchen spezifischen, auf Markup-Sprachen basierenden Strukturierungen von Metadaten, die in erster Linie für die Auszeichnung von Texten genutzt werden, spielen auch allgemeine Metadatenstandards eine wichtige Rolle. Nachfolgend gehen wir auf zwei gängige Standards ein.
Allgemeine Metadatenstandards#
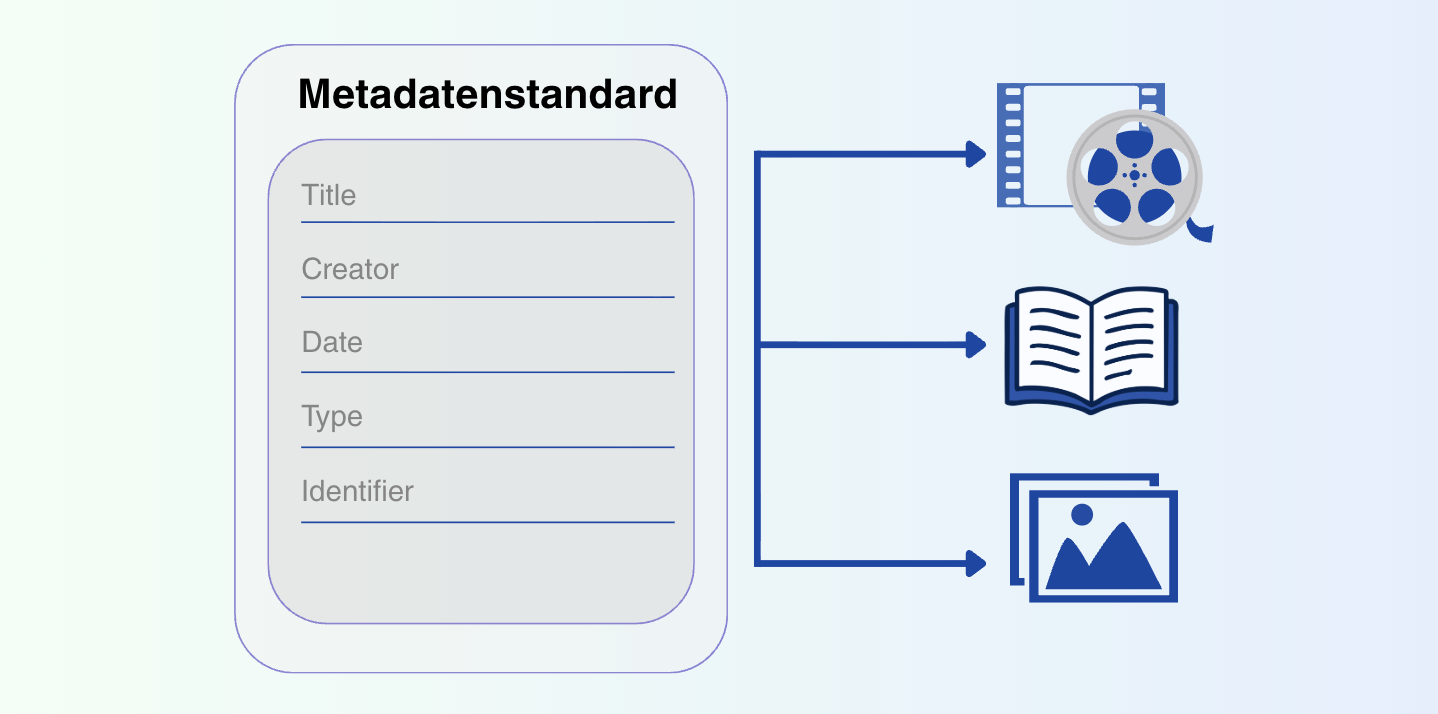
Das System der Strukturierung von Metadaten wird als Metadatenstandard bezeichnet (Drucker, 2021). Metadatenstandards sind also Klassifizierungssysteme. Häufig liegen diese Standards in XML vor und legen bereits eine Struktur fest, wobei der Einsatz von kontrolliertem Vokabular bei der Standardisierung der Inhalte hilft (z. B. Getty Thesaurus).
“Dies reicht von kontrollierten Wortlisten, die fehlerhafte oder unterschiedliche Schreibweisen von Konzepten vereinheitlichen, über Taxonomien und Thesauri, die Über- und Unterbegriffe wie auch Synonyme zu Konzepten enthalten, bis hin zu Ontologien, die Eigenschaften und Relationen zwischen Konzepten modellieren.” (Redaktion von forschungsdaten.info, 2026)
Was sind Taxonomien und Ontologien?
Taxonomien sind Benennungssysteme, bestehend aus kontrolliertem Vokabular, um Dinge und Objekte zu bezeichnen. Ontologien sind Wissensmodelle, die Informationen als relationale Strukturen organisieren und Konzepte systematisieren (Drucker, 2021).
Es gibt eine Vielzahl von fächerübergreifenden, generischen Metadatenstandards. Zwei der bekanntesten stellen wir kurz vor.
Dublin Core#
Ein weit verbreiteter, generischer Standard zur Beschreibung von Dokumenten und anderen Objekten ist der sogenannte Dublin Core. Er besteht aus einem Set aus 15 allgemeinen, weit verbreiteten Elementen (siehe auch hier), darunter beispielsweise title, creator, subject oder description, und wird vielseitig für verschiedenste Ressourcen eingesetzt – von digitalen Objekten in Repositorien über Webseiten bis hin zu Bibliotheksbeständen (Dierkes, 2021).
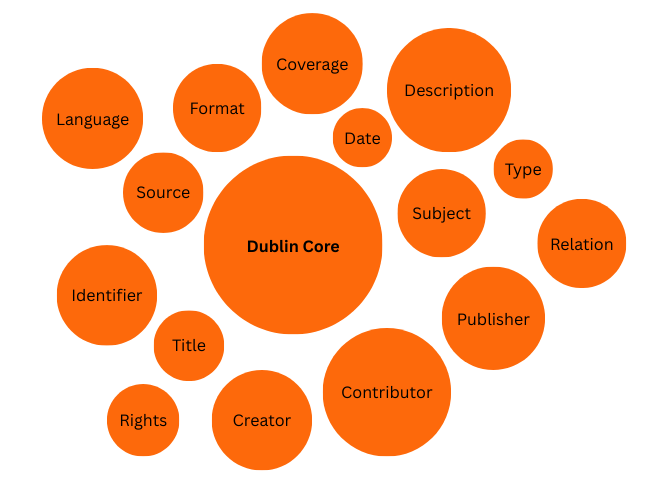
Fig. 3.5 Dublin Core und die 15 Elemente#
Die 15 Elemente des DC und ihre Beschreibungen#
| Element | Beschreibung |
|---|---|
| dc:title | Titel der Ressource (Name, Bezeichnung) |
| dc:creator | Person oder Organisation, die die Ressource geschaffen hat |
| dc:subject | Themen, Schlagworte oder Klassifikationen |
| dc:description | Beschreibung, Zusammenfassung oder Abstract der Ressource |
| dc:publisher | Herausgebende Institution, die die Ressource veröffentlicht |
| dc:contributor | Weitere Personen oder Organisationen, die zur Ressource beigetragen haben |
| dc:date | Relevantes Datum (z. B. Erstellung, Veröffentlichung) |
| dc:type | Art bzw. Typ der Ressource (z. B. Text, Bild, Dataset) |
| dc:format | Format/Medium der Ressource (z. B. pdf, png, audio/mpeg, txt/xml) |
| dc:identifier | Eindeutige Kennung/Identifikator der Ressource (z. B. DOI, URN, ISBN, URL) |
| dc:source | Ursprungsquelle, aus der die Ressource hervorgeht oder abgeleitet ist |
| dc:language | Sprache der Ressource (z. B. ISO-639-Code) |
| dc:relation | Beziehungen zu anderen Ressourcen (z. B. Teil-von, Version, Referenz) |
| dc:coverage | Räumliche oder zeitliche Abdeckung (Ort, Region, Zeitraum) |
| dc:rights | Rechte, Lizenzen und Nutzungsbedingungen der Ressource |
Vor- und Nachteile des DC-Metadatenschemas#
✅ Vorteile
Weit verbreitet und international genutzt
Disziplinübergreifend
Einfacher Einstieg und geringe Komplexität
Interoperabel
❌ Nachteile
Eher ungeeignet für komplexere Forschungs- oder Fachdaten
Keine spezifische Struktur für für Versionierung oder Zitation von Forschungsdaten
Uneinheitliche Nutzungsmöglichkeiten
DataCite#
Das DataCite Schema ist eine strukturierte Liste bestehend aus Kern-Metadaten und ihren Eigenschaften. Es wird insbesondere für die bibliographische Beschreibung von Forschungsdaten, für Publikation, Zitation sowie die Registrierung von DOIs genutzt. Bestimmte Elemente, wie z. B. Autor oder Titel, sind verpflichtende Bestandteile, andere Elemente, wie z. B. Fachbereich oder Beschreibung, werden empfohlen oder sind optional. Das Metadatenschema sowie praxisnahe Anwendungsbeispiele werden in xml und json zur Verfügung gestellt (DataCite Metadata Working Group, 2024).
Ein DataCite Metadatengenerator (aktuell für die Schema Version 4.6.) der Ludwig-Maximilians-Universität München generiert durch Eingabe der Metadatenfelder automatisch ein DataCite-xml-Schema. Dieses kann heruntergeladen und in einem Repositorium der Wahl den Forschungsdaten beigefügt werden. Mehr Informationen zur Anwendung gibt es auf der
GitHub-Page.
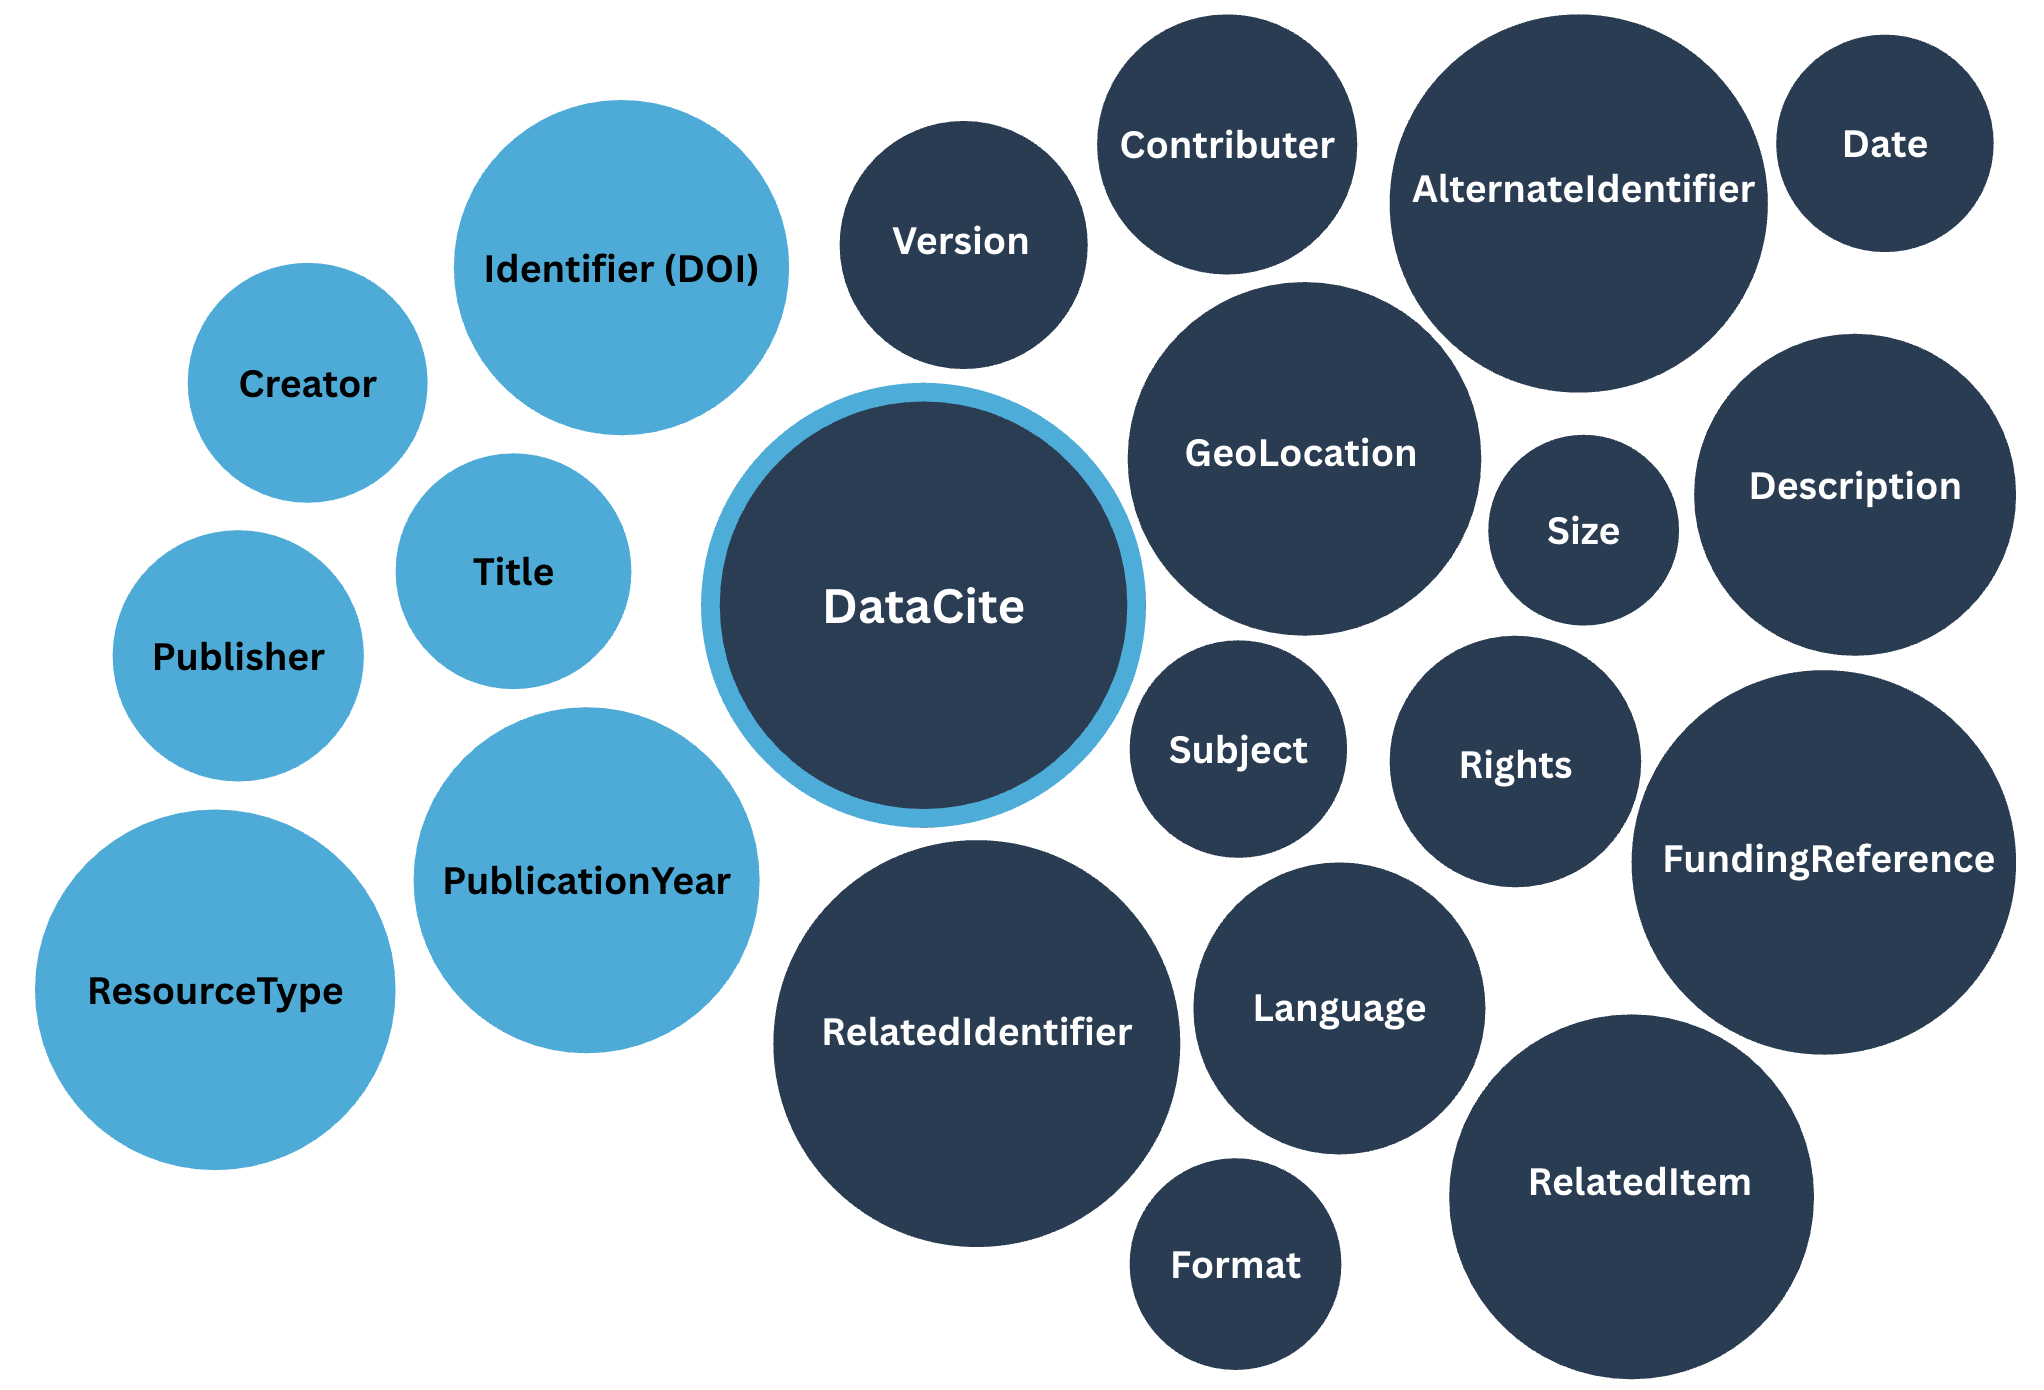
Fig. 3.6 Elemente des DataCite Schemas - notwendig (links) & empfohlen (rechts)#
Vor- und Nachteile des DataCite-Metadatenschemas#
✅ Vorteile
Enge Verknüpfung mit DOIs
Zitierbare Referenzierung von Daten in Publikationen
International etablierter Standard in Forschungsdateninfrastrukturen
Interoperabel
❌ Nachteile
Komplexer und voraussetzungsreich
Weniger geeignet als universeller Minimalstandard
Fokus liegt auf Zitation und Publikation, weniger auf inhaltliche Beschreibungen
Beide Metadatenstandards sind auch in den Digital Humanities etabliert und bieten einen guten Einstieg. Welcher am Ende für das eigene Projekt genutzt werden soll, hängt von verschiedenen Variablen der jeweiligen Datensätze ab. Für eigene Projekte ist es daher ratsam, sich frühzeitig über geeignete Metadatenschemata zu informieren. Der folgende Fragenkatalog soll dabei helfen, eine passende Auswahl zu treffen.
Praxisnaher Fragenkatalog für die Auswahl des Metadatenschemas#
1. Umfang und Komplexität der Daten
- Handelt es sich um komplexe oder überschaubare Daten?
- Gibt es verschiedene Datentypen (z. B. Texte, Audio, Video, Bilder) oder ist der Datenbestand homogen?
2. Inhaltliche Aspekte
- Welche Bestandteile der Datensätze sollen in den Metadatendokumentationen beschrieben werden (z. B. Inhalt, Struktur, Entstehungskontext, Methoden, Rechte)?
- Werden grundlegende bibliographische Angaben benötigt oder fachspezifische?
3. Publikation und Zitation
- Soll das Schema insbesondere für die Publikation und Zitation genutzt werden (DOIs)?
- Sollen die Forschungsdaten langfristig referenzierbar sein?
4. Ressourcen und Kompetenzniveau
- Welche zeitlichen und technischen Ressourcen bzw. Kapazitäten gibt es im Projekt, um sich ggf. auch in komplexere Schemata einzuarbeiten?
- Stehen Personen mit Vorwissen zu Metadatenstandards oder technischen Formaten (z. B.
xml,tei,rdf) zur Verfügung?
5. Minimalstandard oder mehr?
- Reicht für den Zweck des Projektes ein Minimalstandard (z. B. wenige, generische Felder), oder sind detaillierte, fachlich spezialisierte Metadaten erforderlich?
Allgemeine, generische Schemata sind ein guter Einstieg für Projektanfänge. Häufig decken sie jedoch die Erfordernisse des jeweiligen Fachs nicht genügend ab. In der Praxis werden Metadatenschemata daher konfiguriert oder angepasst, um die Fach- bzw. Projektspezifika zu adressieren (Drucker, 2021). Daran anknüpfend rückt im nächsten Kapitel die Filmwissenschaft in den Fokus, um fachspezifische Metadatenstandards exemplarisch zu vertiefen.
Literatur#
Dierkes, J. (2021). Putnings, M., Neuroth, H., & Neumann, J. (Eds.). Planung, Beschreibung und Dokumentation von Forschungsdaten. Praxishandbuch Forschungsdatenmanagement (pp. 303–326). De Gruyter. doi:10.1515/9783110657807-018 (1,2)
Drucker, J. (2021). Metadata, Markup, and Data Description. The Digital Humanities Coursebook: An Introduction to Digital Methods for Research and Scholarship, 52–69. Routledge. doi:10.4324/9781003106531-4 (1,2,3,4,5,6,7)
Riley, J. (2017). Understanding Metadata: What Is Metadata, and What Is It For? A Primer. National Information Standards Organization (NISO). URL: https://www.niso.org/publications/understanding-metadata-2017. (1,2)
DataCite Metadata Working Group (2024). DataCite Metadata Schema Documentation for the Publication and Citation of Research Data and Other Research Outputs: Version 4.6. doi:10.14454/mzv1-5b55
Freie Universität Berlin (o. J.). Metadaten. [Abgerufen: 2026-08-19]. URL: https://www.fu-berlin.de/sites/forschungsdatenmanagement/in-der-praxis/durchfuehrung/metadaten.html
Redaktion von forschungsdaten.info (2026). Metadaten und Metadatenstandards. [Abgerufen: 2026-08-19]. URL: https://forschungsdaten.info/fdm-allgemein/beschreiben-und-dokumentieren/metadaten-und-metadatenstandards (1,2)
Wikipedia (2026). Auszeichnungssprache. [Abgerufen: 2026-08-19]. URL: https://de.wikipedia.org/wiki/Auszeichnungssprache