2.4. Erhebung und Nachnutzung#
Da diese Fallstudie sich auf die Organisation, Aufbereitung und Publikation von Daten entlang des filmwissenschaftlichen SFB-Teilprojekts der FU konzentriert, werden hier lediglich einige gängige Methoden, Beispiele und Hinweise für die Datenerhebung vorgestellt - es besteht kein Anspruch auf Vollständigkeit.
Erhebung von Forschungsdaten#
Je nach technischem Erfahrungsniveau stehen unterschiedliche Methoden und Verfahren zur Verfügung, um Forschungsdaten in der Film- und Medienwissenschaft zu erheben oder zu generieren. Im Folgenden werden gängige Methoden vorgestellt.
Erhebung mit digitalen Annotationstools#
⟶ Niveau: Basis
Für filmanalytische Untersuchungen eignen sich insbesondere digitale Annotationswerkzeuge wie Advene, (zum Beispiel in Verbindung mit dem AdA-Toolkit), ELAN, VIAN oder FrameTrail.
Das Erstellen von Annotationsdaten erfordert i.d.R. nur begrenztes technisches Vorwissen. Die Handhabung kann auf Grundlage verfügbarer Manuals, Open Educational Resources oder Projektdokumentationen schnell erlernt werden. Die jeweiligen Plattformen bieten oftmals ausführliche Dokumentationen und Tutorials an.
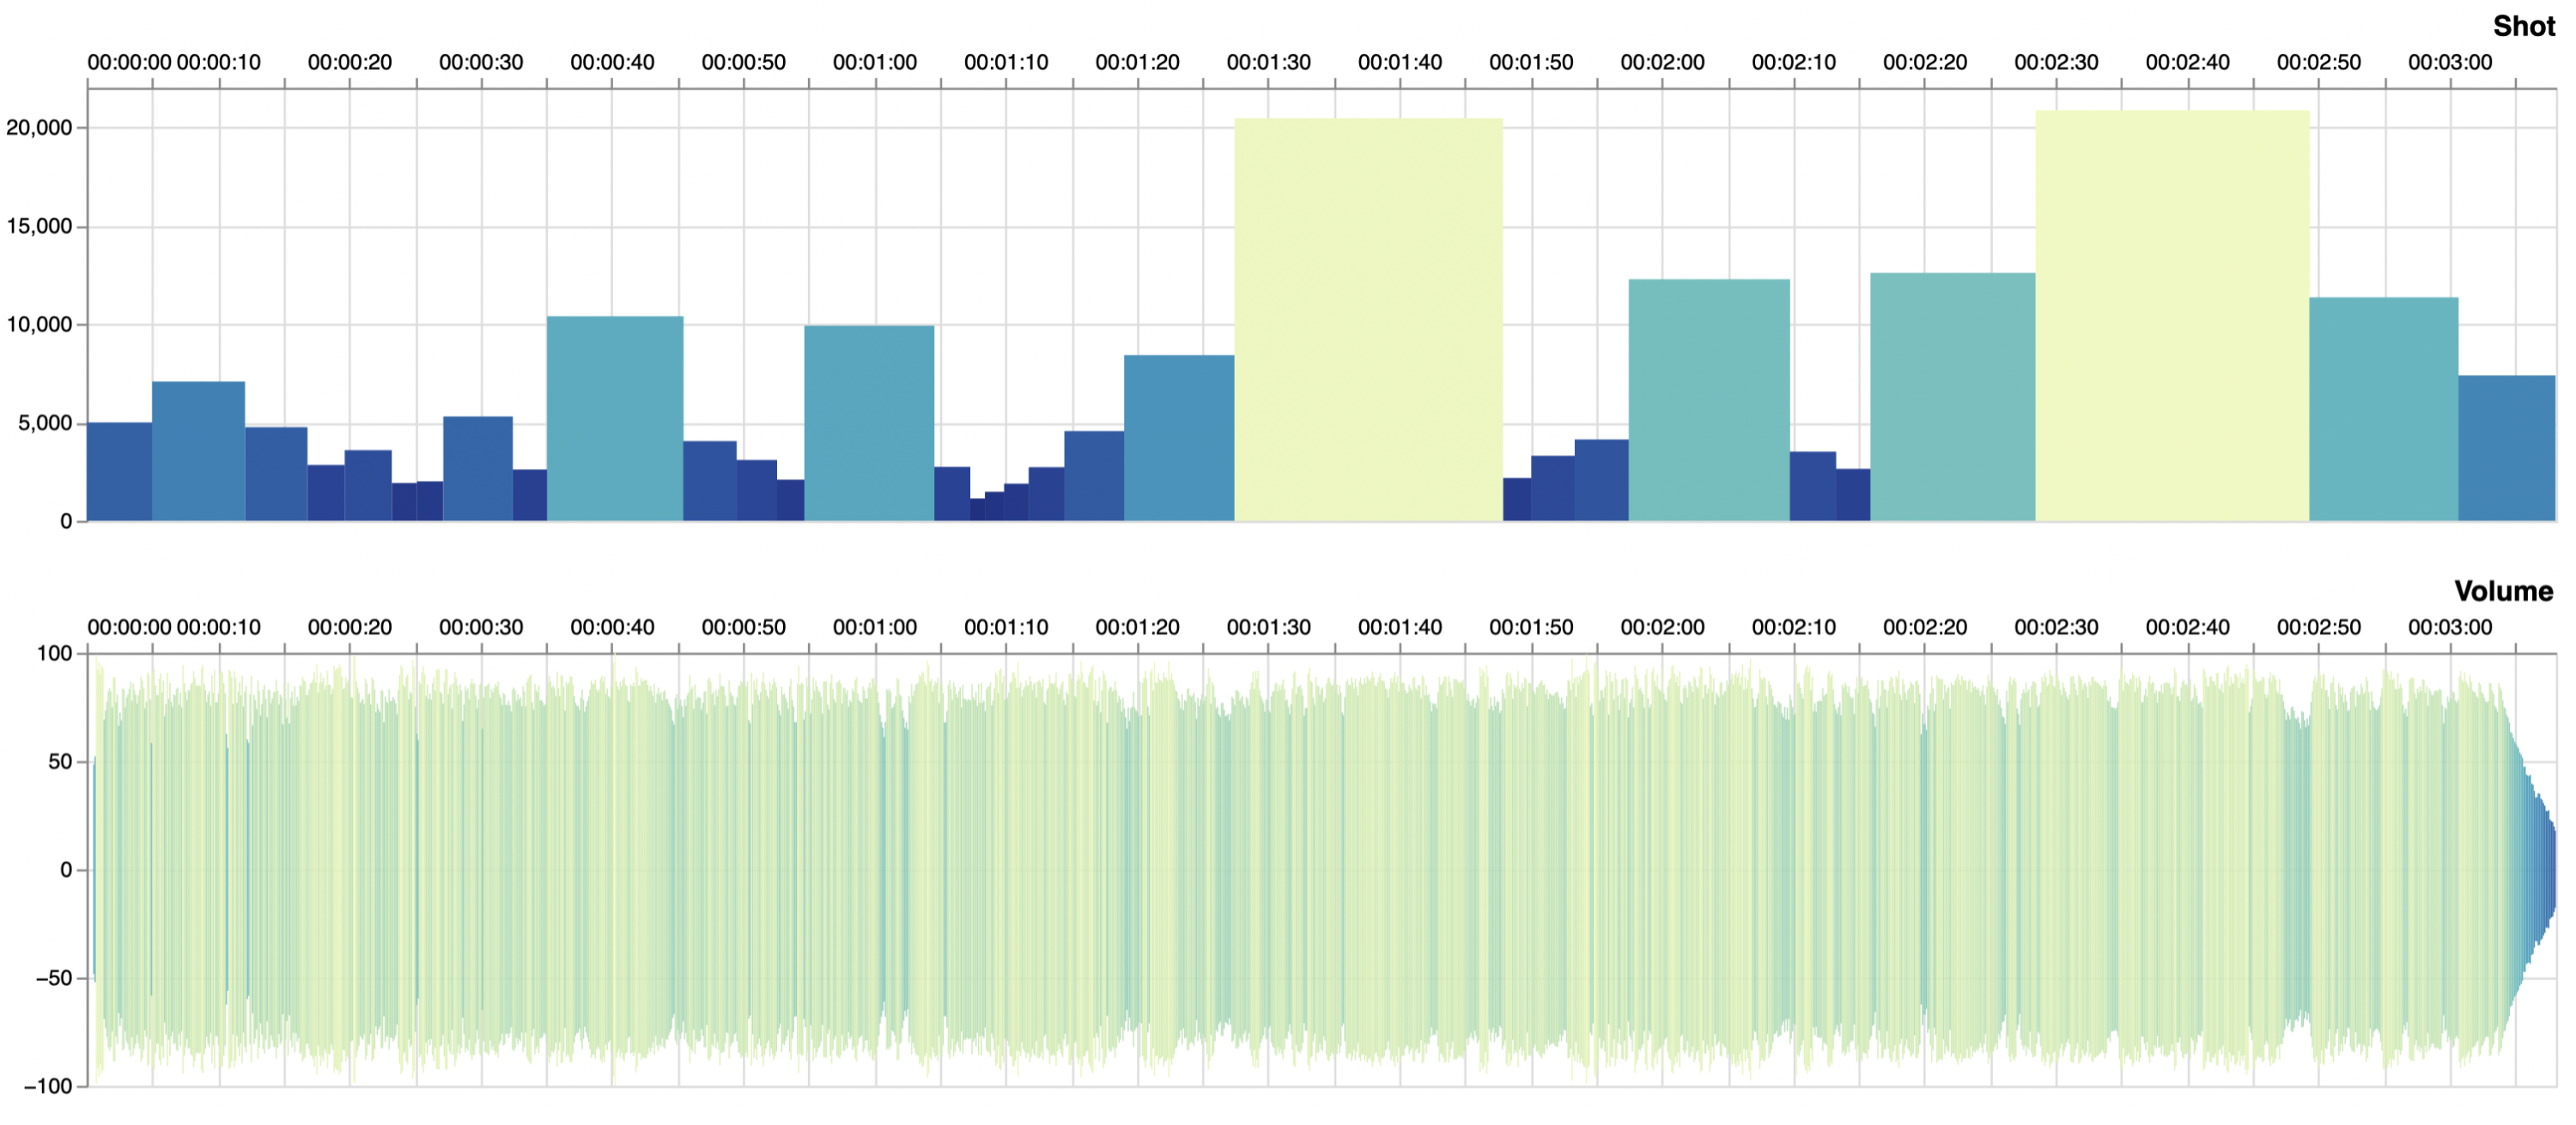
Fig. 2.9 Visualisierung von Annotationsdaten mit der AdA-Timeline#
Annotationen erstellen mit dem AdA-Toolkit
In unserer QUADRIGA Fallstudie: “Affektrhetorik in Online-Videos zur Klimakrise. Datengestützte Analysen audiovisueller Muster” wird gezeigt, wie mit der für die Filmanalyse entwickelten Analyseontologie AdA (Toolkit) in Advene Annotationsdaten erstellt und visualisiert werden können.
Data Dumps, APIs und SPARQL-Abfragen#
⟶ Niveau: Fortgeschritten
Neben eigenen Erhebungen können Forschungsdaten auch über bestehende Datenquellen und Datensammelbanken bzw. Plattformen gewonnen werden.
Hierzu zählen insbesondere:
Was sind Data Dumps?
Data Dumps sind große bereitgestellte Datenmengen, die von einem Computersystem, einer Datei oder einem Gerät auf ein anderes übertragen werden (Cambridge University Press & Assessment, o. J.).
Technisch versierte Nutzer:innen können API-Schnittstellen kommerzieller und nicht-kommerzieller Dienste nutzen – z. B. IMDb Non-Commercial Datasets, The Movie Database (TMDb – für nicht-kommerzielle Nutzung) oder die OpenSubtitles REST API.
Was sind API-Schnittstellen?
Eine API (Application Programming Interface) ist eine Programmierschnittstelle zwischen verschiedenen Softwareanwendungen. Sie ermöglicht die automatisierte Kommunikation zwischen Programmen, um Daten oder Funktionen auszutauschen, also eine Form der “Maschine-zu-Maschine”-Kommunikation. Über APIs können Entwickler:innen auf Inhalte, Daten oder Dienste anderer Systeme zugreifen und diese in eigene Anwendungen integrieren (Poggel, 2025).
Ebenso bietet beispielsweise das Portal Wikidata mittes eines SPARQL-Endpoints semantische Abfragen an. Anleitungen und Abfragebeispiele sind in den Dokumentationen der Seite zu finden.
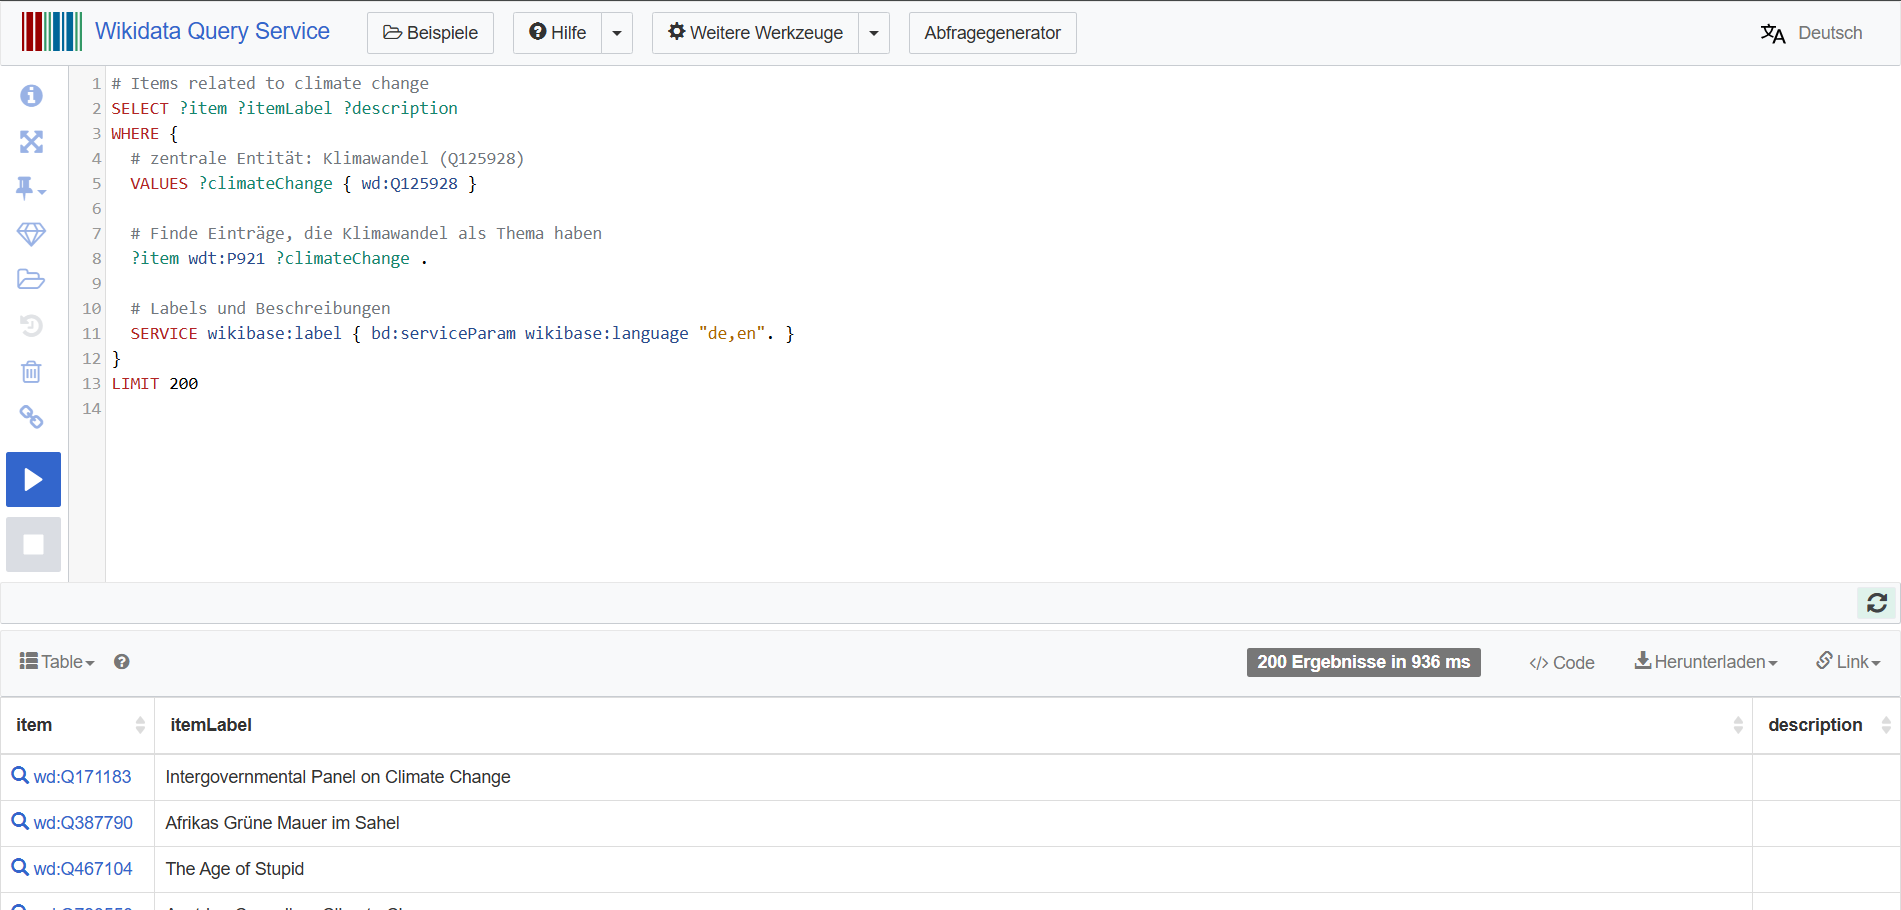
Fig. 2.10 Beispiel einer SPARQL-Abfrage mit dem Schlagwort “climate change”#
Was ist ein SPARQL-Endpoint?
SPARQL ist eine “graphenbasierte Abfragesprache”, durch die Daten aus der webbasierten Beschreibungssprache RDF (Resource Description Framework) abgefragt werden können. Ein SPARQL-Endpoint ist eine URL, über die Benutzer:innen diese Abfragen stellen können. Aus großen Datenmengen, die im RDF-Format vorliegen, können mit SPARQL-Abfragen also gezielt Informationen abgerufen werden (Wikipedia, 2026).
Erhebung mit Webscrapingverfahren#
⟶ Niveau: Expert:in
Webscraping für fortgeschrittene Nutzer:innen mit Programmierkenntnissen (Python, R, JavaScript)
Webscraping ist ein Verfahren der automatisierten Extraktion von Daten aus Webseiten. Scraper - das sind Codeskripte - analysieren die html-Struktur einer Website und filtern bestimmte vorgegebene Informationen raus, die dann in einer Tabelle (dataframe) strukturiert gespeichert werden können.
Unter Berücksichtigung rechtlicher Vorgaben und der jeweiligen robots.txt kann Webscraping als digitales Verfahren eingesetzt werden, um beispielsweise Filmdaten zu extrahieren, die nicht über Schnittstellen oder offene Data Dumps zugänglich sind.
In jedem Fall sind Lizenzbedingungen, Nutzungsrechte und Datenschutz zu prüfen, insbesondere wenn Daten kommerzieller Anbieter (z. B. IMDb, TMDb) nachgenutzt werden sollen.
Was ist eine “robots.txt”?
Eine robots.txt ist eine einfache Textdatei in dem Hauptverzeichnis einer Website. Darin können Websiterbetreiber:innen vorgegeben, aus welchen Bereichen automatisierte Programme Daten auslesen können und aus welchen nicht. Teilweise enthält sie auch Angaben dazu, wie viel Zeit zwischen einzelnen Anfragen liegen soll, damit der Server nicht überlastet wird (Koster et al., 2022, Poggel, 2025).
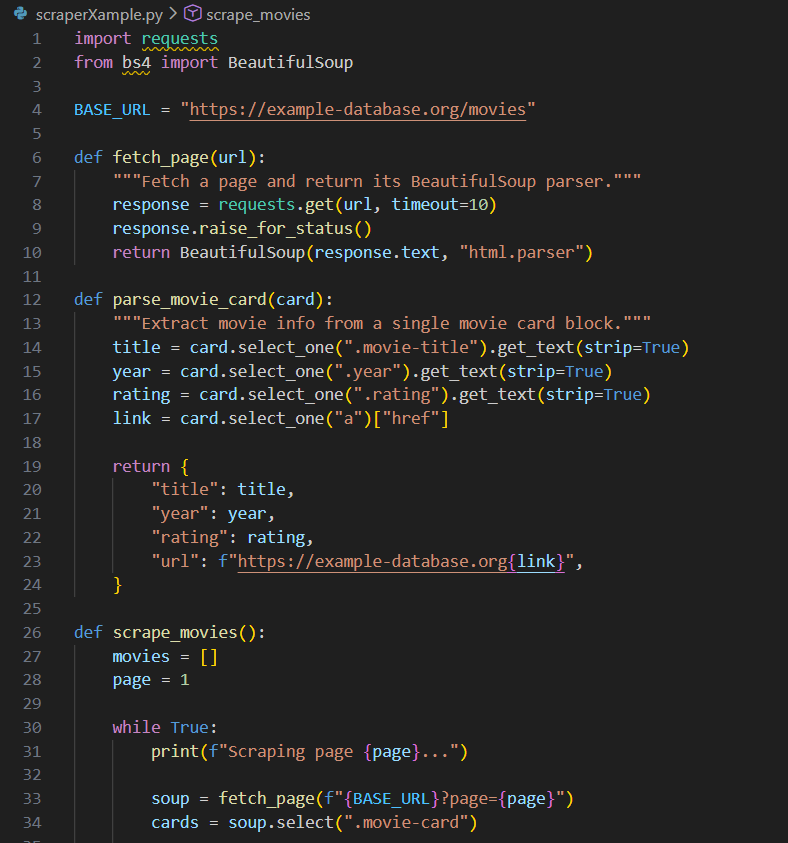
Fig. 2.11 Illustratives Beispiel eines Webscraping-Skripts#
Siehe auch:
Detaillierte Informationen zum Thema Webscraping gibt es in unserer QUADRIGA Fallstudie: “Quantitative Analyse der kommunikativen Barrierearmut des Berliner Senats (2011-2024). Eine Fallstudie”
Nachnutzung von Forschungsdaten#
Ergänzend zur eigenen Datenerhebung besteht ebenso die Möglichkeit, auf bereits vorhandene oder veröffentlichte Forschungsdaten anderer Projekte zurückzugreifen.
Die Nachnutzung solcher Daten kann den Forschungsprozess erheblich bereichern, neue kreative Wissensdynamiken entstehen lassen und den Austausch zwischen verschiedenen Institutionen und Akteur:innen anregen (Dang, 2020). Der Prozess wissenschaftlicher Erkenntnisgewinnung erweist sich als umso stabiler und nachhaltiger, je mehr auf dem vorhandenen Wissen der Fachdisziplin aufgebaut wird; dies schließt die Miteinbeziehung oder gar Neuperspektivierung bereits existierender Daten ein (RatSWD, 2023). So können etwa vergleichende Analysen durchgeführt werden, Annotationspraktiken angeeignet, übernommen und erweitert oder bestehende Datensätze weiterentwickelt werden. Voraussetzung für eine “kreative und inklusive Wissensproduktion” (Dang, 2020) ist die uneingeschränkte Verfügbarmachung von Daten, so Dang. Welche Prinzipien hierbei eine Rolle spielen, werden wir im Kapitel 2.5. Forschungsdatenmanagement diskutieren.
Arten der Nachnutzung#
Je nach Forschungsziel kann die Nachnutzung sehr unterschiedlich ausfallen:
Analytisch: Annotations- oder Transkriptionsdaten können nachgenutzt werden, um neue Fragestellungen, z. B. zu Bewegungsmustern oder Farbkompositionen, zu prüfen.
Vergleichend: Datensätze können, unter der Einbeziehung einer spezifischen wissenschaftlichen Fragestellung oder These, miteinander verglichen werden; ebenso können Lücken aufgedeckt und diskutiert werden.
Kuratierend: Daten aus offenen Registern und Repositorien können in die eigene Forschung eingebunden werden, um bestehende Datensammlungen anzureichern oder neue Zugangswege zu schaffen (z. B. Datenaggregation von Metadaten aus Filmdatenbanken).
Didaktisch: Forschungsdaten können für Lehrzwecke, z. B. als Übungsmaterial in Seminaren, genutzt werden (z. B. Nachnutzung von bestehenden OERs oder Tutorials).
Für die Nachnutzung bietet es sich an, zunächst nach offenen Repositorien und Infrastrukturen zu suchen, in denen Forschungsdaten der Film- und Medienwissenschaft publiziert und verfügbar gemacht werden, wie etwa:
… und viele mehr
Ressourcenübersicht
Im Kapitel 4.3. Ressourcen und Entscheidungshilfen gehen wir auf konkrete Beispiele im Detail ein – sowohl auf publizierte film- und medienwissenschaftliche Daten aus verschiedenen Projekten und Institutionen als auch auf gängige Repositorien und Datenbanken. Eine ausführliche Übersicht relevanter Repositorien/Projekte/Tools/Infrastrukturen stellen wir dort ebenfalls kommentiert bereit.
Ethische Aspekte und gute wissenschaftliche Praxis#
Wichtig ist, die Nachnutzung transparent zu kommunizieren und ordnungsgemäß zu zitieren, sodass Herkunft, Kontext und Lizenzbedingungen nachvollziehbar bleiben. Nachgenutzte Datensätze sollten also ähnlich wie wissenschaftliche Publikationen behandelt werden, d. h. mit vollständiger Quellenangabe, persistenten Identifikatoren (Kapitel 6.1.) (z. B. DOI falls vorhanden) und Verweis auf Lizenzbedingungen (Kapitel 6.1.).
Was ist eine DOI?
Die Abkürzung DOI steht für Digital Object Identifier und ist ein eindeutiger und permanenter Identifikator für digitale Objekte wie beispielsweise wissenschaftliche Aufsätze, Publikationen, Forschungsdaten oder Videos. Ähnlich wie eine ISBN-Nummer dienen DOI’s dazu, Objekte im Internet dauerhaft auffindbar und zitierbar zu machen. Mehr Infos zum DOI gibt es auch im Kapitel Versionierung, Lizenzierung, Zitierfähigkeit (Kapitel 6.1.).
Wie bei anderen Datentypen gilt auch hier: Nachgenutzte Daten sind nie neutral oder objektiv. Sie sind Ergebnis von Auswahlprozessen, institutionellen Logiken und Strukturen sowie technologischen Bedingungen. Dies betrifft sowohl die Auswahl der erfassten Gegenstände/Filme (gibt es bevorzugte Archivbestände? Ist der untersuchte Filmkorpus westlich geprägt?) als auch die technischen Formate oder Klassifikationssysteme, die bestimmte Formen der Repräsentation bevorzugen und andere ausschließen können (Dang, 2020, Drucker, 2021).
Neben der Betrachtung der Relevanz und des Umgangs mit nachgenutztem Datenmaterial richtet sich der Fokus im nächsten Abschnitt auf das Forschungsdatenmanagement selbst.
Literatur#
Dang, S.-M. (2020). Forschungsdatenmanagement in der Filmwissenschaft: Daten, Praktiken und Erkenntnisprozesse. montage AV, 29(1), 119–140. doi:10.25969/mediarep/21687 (1,2,3)
Drucker, J. (2021). Digital Humanities Overview. The Digital Humanities Coursebook: An Introduction to Digital Methods for Research and Scholarship, 1–18. Routledge. doi:10.4324/9781003106531-1
Koster, M., Illyes, G., Zeller, H., & Sassman, L. (2022). Robots Exclusion Protocol. URL: https://datatracker.ietf.org/doc/html/rfc9309, doi:10.17487/RFC9309
Poggel, L. (2025). Webscraping mit Python für Geisteswissenschaften. Jupyter Book zum Seminar an der Freien Universität Berlin, Wintersemester 2025/26. [Abgerufen: 2026-08-17]. URL: https://lipogg.github.io/webscraping-mit-python/intro.html (1,2)
Cambridge University Press & Assessment (o. J.). Data Dump. [Abgerufen: 2026-08-17]. URL: https://dictionary.cambridge.org/de/worterbuch/englisch/data-dump
RatSWD (2023). Forschungsdatenmanagement in kleinen Forschungsprojekten: Eine Handreichung für die Praxis. Rat für Sozial- und Wirtschaftsdaten. RatSWD Output Series, 7. Berufungsperiode, Nr. 3. doi:10.17620/02671.72
Wikipedia (2026). SPARQL. [Abgerufen: 2026-08-17]. URL: https://de.wikipedia.org/w/index.php?title=SPARQL&oldid=268483407